
Ogni sistema di intelligenza artificiale per la lingua dei segni è costruito a partire da registrazioni di persone che segnano. Chi fossero queste persone, cosa abbiano accettato, quanto siano state pagate e se possano mai riottenere i propri volti sono domande a cui il mercato non ha risposto e che la maggior parte degli acquirenti non si è mai posta.
Il volto è il dato
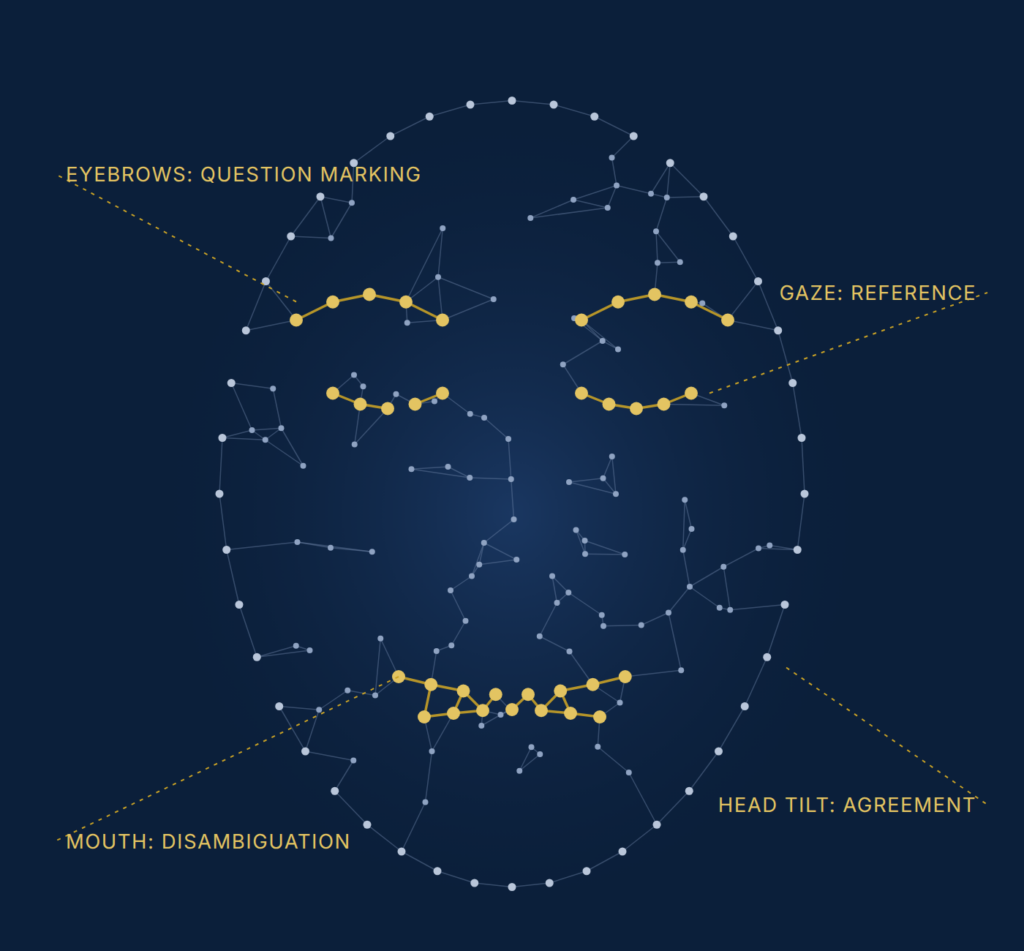
Nelle tecnologie per il linguaggio parlato e scritto, i dati di addestramento e la persona possono di solito essere separati. Una frase può essere privata del suo autore. Una voce può essere trasformata fino a renderla irriconoscibile, mentre le parole restano. Le lingue dei segni non consentono questa separazione, perché la lingua si produce sul corpo. Le mani portano il lessico, ma la grammatica è distribuita sul volto: la posizione delle sopracciglia segna le domande, i pattern della bocca disambiguano i segni, l'inclinazione della testa e la direzione dello sguardo stabiliscono riferimento e accordo. Una registrazione di un segnante con il volto sfocato non è un campione linguistico de-identificato. È un campione corrotto.
Questo ha una conseguenza che la letteratura sull'apprendimento automatico riconosce da tempo e che la letteratura sugli appalti non ha ancora colto. Un corpus di lingua dei segni è, necessariamente, una raccolta di registrazioni identificabili di persone specifiche. La comunità dei segnanti in qualsiasi paese è ristretta, e la revisione interdisciplinare dei dataset di intelligenza artificiale per la lingua dei segni condotta da Bragg e colleghi ha osservato che “a causa delle dimensioni ridotte della comunità sorda, può essere possibile identificare personalmente i segnanti nei video”[1]. Un modello addestrato su un simile corpus ha appreso dai volti di queste persone. Se il sistema genera segni, ha imparato a produrre volti che somigliano ai loro. La domanda su chi abbia costruito il sistema con la propria lingua dei segni non è quindi una domanda astratta di etica dei dati. È una domanda su individui nominati, rintracciabili, la cui immagine fa ora parte di un prodotto.
Una registrazione di un segnante con il volto sfocato non è un campione linguistico de-identificato. È un campione corrotto.
Da dove provengono i corpora
I corpora documentati alla base della ricerca pubblicata sul riconoscimento e la generazione della lingua dei segni sono stati assemblati con un numero ristretto di metodi, e il metodo di assemblaggio determina quasi tutto ciò che segue.
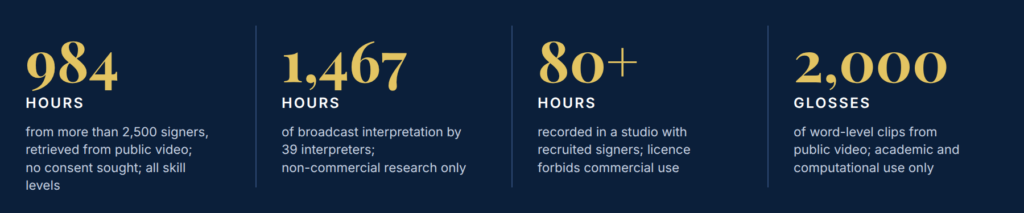
Il primo metodo è la raccolta da video pubblici. Un dataset di lingua dei segni americana a livello di parola, ampiamente utilizzato, è stato compilato scaricando video da YouTube e da siti di insegnamento della lingua dei segni, organizzato in circa duemila glosse, e rilasciato secondo il Computational Use of Data Agreement di Microsoft con la dichiarazione che tutti i dati “sono destinati esclusivamente all'uso accademico e computazionale” e che “non è consentito alcun uso commerciale”[2]. La sua documentazione registra un identificativo del segnante per ogni clip ma non contiene alcuna dichiarazione sul consenso, la fluenza o la consapevolezza dei segnanti riguardo al fatto che il loro video fosse stato raccolto. Un successivo esame linguistico ha riscontrato che le etichette glossa in inglese erano incoerenti in modo “diffuso”, con lo stesso segno etichettato con parole diverse e la stessa parola applicata a segni diversi[3]. Un corpus più ampio, pubblicato nel 2023, ha raccolto 984 ore di filmati provenienti da oltre 2.500 segnanti recuperando video pubblici di YouTube etichettati come contenuti di lingua dei segni; i suoi autori spiegano di aver incluso “video di tutti i livelli di abilità e stili di segnatura, purché comprensibili per un utente ASL”, che rilasciano solo identificativi dei video e non i video stessi, e che la via di ritiro per un creatore è rendere il video privato o eliminarlo[4].
Il secondo metodo è l'interpretazione televisiva. Il più grande corpus di lingua dei segni britannica consiste in circa 1.467 ore di programmi BBC con un interprete in sovrimpressione, prodotti da 39 interpreti in totale, ed è disponibile per la ricerca non commerciale secondo un accordo di condivisione dati con l'emittente che obbliga i ricercatori a eliminare porzioni o l'intero dataset su richiesta[5]. Il corpus tedesco delle previsioni meteo, su cui si sono basati i primi risultati di traduzione neurale della lingua dei segni, è stato costruito allo stesso modo, a partire da interpreti televisivi che rendevano il testo di un presentatore udente[6]. Questi interpreti erano pagati per interpretare una trasmissione. Non erano pagati per fornire un corpus di addestramento, e la lingua che hanno prodotto è un'interpretazione sotto pressione temporale a partire da una fonte parlata. De Sisto e colleghi avvertono che usare “dati non nativi e/o interpretati per addestrare sistemi di traduzione che dovrebbero essere in grado di riconoscere e generare un linguaggio spontaneo autentico/nativo porterà a traduzioni meno naturali e molto probabilmente imprecise”, e descrivono il risultato come una forma di traduzionese in cui il flusso segnato “sarà sempre in qualche modo influenzato dalla lingua parlata di origine”[7].
Il terzo metodo è la registrazione in studio con segnanti reclutati. L'esempio più noto è un corpus di oltre ottanta ore di lingua dei segni americana continua, registrato in condizioni controllate con partecipanti consenzienti e rilasciato con licenza Creative Commons che vieta l'uso commerciale[8]. Questo è il modello che più si avvicina all'etica della ricerca ordinaria: partecipanti reclutati, informati, compensati in quanto partecipanti alla ricerca, e registrati per uno scopo dichiarato. È anche il modo più costoso di costruire un corpus, motivo per cui produce i corpora più piccoli.
Il quarto metodo è la raccolta privata da parte delle aziende che vendono prodotti di intelligenza artificiale per la lingua dei segni. Questo è il metodo che più conta per un acquirente, ed è quello su cui si documenta di meno. I dati di addestramento propri di un fornitore non compaiono in alcun articolo sui dataset. Non hanno alcuna pagina di licenza. Se siano stati estratti da scraping, acquistati, registrati con segnanti assunti, forniti dagli utenti del prodotto, o assemblati a partire dai corpora di ricerca pubblici sopra descritti, con o senza riguardo alle relative restrizioni d'uso, non è visibile dall'esterno dell'azienda.
Quattro domande a cui risponde il metodo di assemblaggio
Messi a confronto, i corpora documentati rispondono a quattro domande in quattro modi diversi, e le differenze sono l'intero oggetto della questione.
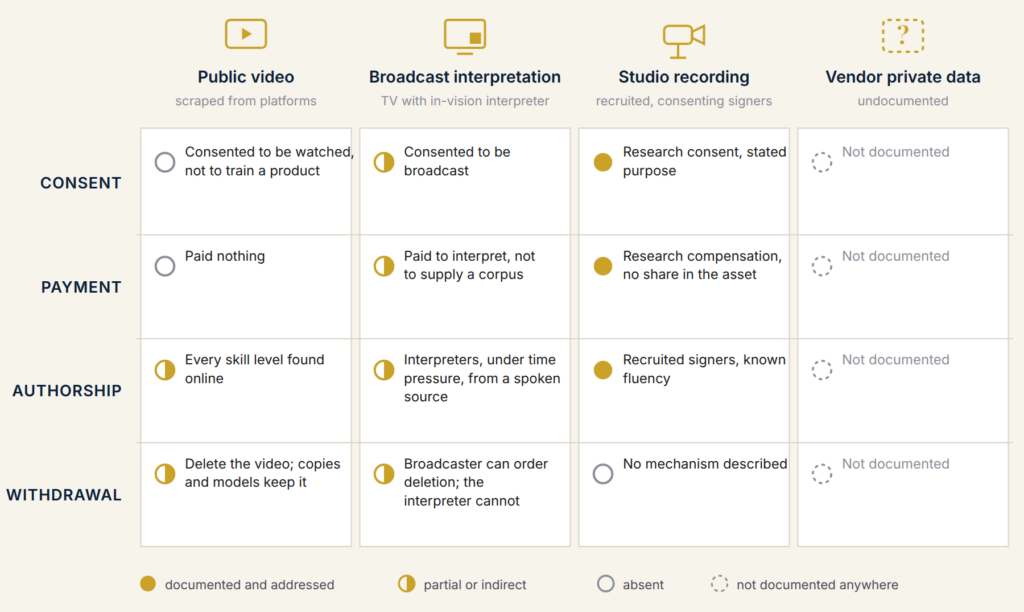
La prima domanda riguarda il consenso. Una persona che ha caricato un video per insegnare un segno ha acconsentito a essere osservata. Se tale consenso si estenda a essere scomposta in caratteristiche di addestramento per un prodotto commerciale è una domanda a cui i termini di servizio della piattaforma rispondono a favore della piattaforma stessa, e a cui la comprensione della persona quasi certamente non corrisponde. Gli interpreti televisivi hanno acconsentito a essere trasmessi. I partecipanti in studio hanno acconsentito alla ricerca. In nessuno dei casi documentati al di fuori dei corpora di studio vi è prova che al segnante sia stato chiesto se il suo segnare potesse essere usato per costruire una macchina che segna.
In nessuno dei casi documentati al di fuori dei corpora di studio vi è prova che al segnante sia stato chiesto se il suo segnare potesse essere usato per costruire una macchina che segna.
La seconda domanda riguarda il pagamento. Le persone il cui segnare ha prodotto i corpora più grandi non sono state pagate per questo, perché i corpora sono stati costruiti a partire da un lavoro che avevano già svolto per altri motivi o per nessun motivo. Gli interpreti sono stati pagati dalle emittenti per interpretare. Chi ha caricato i video non è stato pagato da nessuno. Solo i partecipanti in studio hanno ricevuto qualcosa, e hanno ricevuto un compenso da ricerca, non una quota di un bene commerciale. Bragg e colleghi osservano che gli accordi sui dati “possono specificare un compenso per l'uso, descrivere gli usi consentiti dei dati” e stabilire limiti temporali all'uso[1]. I corpora pubblici documentati non lo fanno perché non sono stati costruiti su accordi con i segnanti. Sono stati costruiti su accordi con piattaforme ed emittenti.
La terza domanda riguarda la paternità, nel senso di di chi sia la lingua che il sistema ha appreso. Un corpus di interpreti ha appreso l'interpretazione, con il suo ritardo, la sua ombra della lingua di origine e il suo registro professionale. Un corpus con ogni livello di abilità reperito su una piattaforma video ha appreso una miscela di segnatura nativa, segnatura di seconda lingua e segnatura da apprendista, ponderata in base a ciò che le persone hanno scelto di caricare. Bragg e colleghi osservano che “la maggioranza degli utenti della lingua dei segni potrebbe non essere sorda, e i segnanti di prima lingua costituiscono solo una piccola frazione degli utenti per la maggior parte delle lingue dei segni”[1], e un corpus assemblato da video pubblici eredita quella proporzione. Una revisione condotta da persone sorde di 101 articoli sull'intelligenza artificiale per la lingua dei segni ha riscontrato che il settore è “dominato da ricercatori udenti che non segnano” ed è “guidato da ciò che le decisioni risultano più convenienti o percepite come importanti per i ricercatori udenti”[9]. Anche la convenienza determina quale corpus venga utilizzato. La domanda su quale lingua parli un sistema è risolta, in pratica, da quali registrazioni fossero più facili da ottenere.
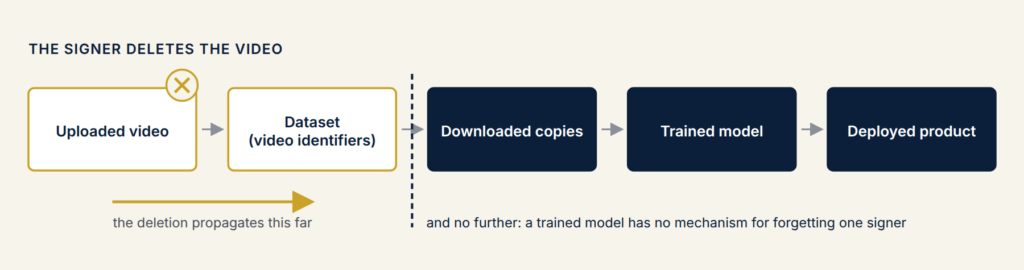
La quarta domanda riguarda il ritiro. Una persona che compare in un dataset assemblato da video pubblici può eliminare il video. Se il dataset è stato distribuito come identificativi di video, l'eliminazione si propaga a chiunque non abbia già scaricato la clip. Non si propaga a chi l'ha già scaricata, e non si propaga in un modello che è stato addestrato prima dell'eliminazione. Il corpus televisivo è l'unico caso documentato con un obbligo contrattuale di eliminazione, e tale obbligo va dall'emittente al ricercatore, non dall'interprete a chiunque altro. Un modello addestrato non ha alcun meccanismo per dimenticare un singolo segnante. Il ritiro, nel senso in cui una persona lo intenderebbe, non è disponibile in nessun punto del panorama documentato una volta che l'addestramento ha avuto luogo.
Il vuoto nella legge
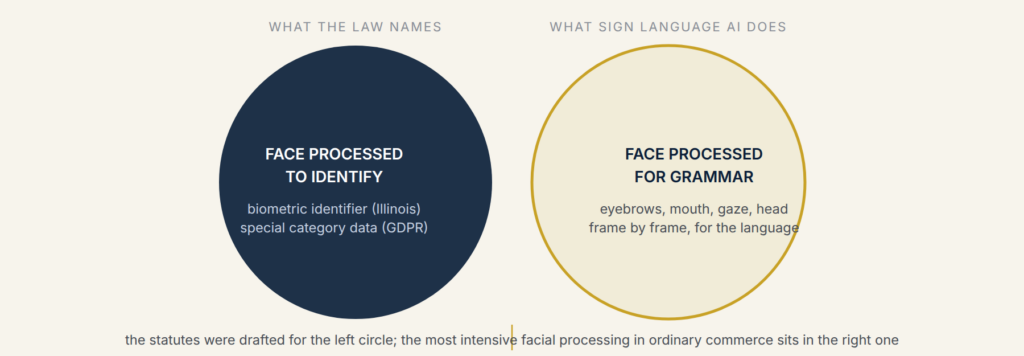
I lettori che presumono che i volti siano protetti dal diritto sulla privacy biometrica dovrebbero osservare come quella legge sia redatta. L'Illinois Biometric Information Privacy Act, il più rigoroso tra gli statuti americani, definisce un identificatore biometrico come “una scansione della retina o dell'iride, un'impronta digitale, un'impronta vocale o una scansione della geometria della mano o del volto” ed esclude espressamente le fotografie dalla definizione; richiede un consenso scritto prima che un'entità privata raccolga tale identificatore[10]. Secondo i regimi di protezione dei dati europeo e del Regno Unito, i dati biometrici diventano dati di categoria particolare quando sono trattati “allo scopo di identificare in modo univoco una persona fisica”, e l'autorità di regolamentazione del Regno Unito è esplicita nell'affermare che fotografie e video ordinari di persone “non sono automaticamente dati biometrici anche se utilizzati a fini identificativi”; lo status di categoria particolare si applica quando un trattamento tecnico specifico produce un modello per la corrispondenza[11].
Un modello di lingua dei segni elabora il volto con un dettaglio straordinario. Estrae la posizione delle sopracciglia, la forma della bocca, la direzione dello sguardo e il movimento della testa fotogramma per fotogramma, perché queste caratteristiche sono la grammatica. Ma non le elabora per identificare il segnante. Le elabora per apprendere la lingua. Alla lettera degli statuti, questo è esattamente lo scopo per cui le categorie biometriche non sono state scritte. Il trattamento computazionale più intensivo del volto di una persona esistente nel commercio ordinario potrebbe quindi collocarsi al di fuori delle tutele redatte pensando ai volti, poiché i legislatori hanno presupposto che un volto sarebbe stato elaborato solo per dire a chi appartiene. Questa non è una conclusione legale consolidata e Novara Consulting Group non offre alcun parere legale su alcuna giurisdizione. È un'osservazione che le categorie non si adattano, e che a un fornitore a cui venga chiesto se il suo corpus sia “dati biometrici” potrebbe rispondere di no in assoluta buona fede pur detenendo migliaia di ore di volti sordi identificabili.
Le licenze sono una questione separata e più semplice. Il corpus a livello di parola consente solo l'uso accademico e computazionale. Il corpus di studio è non commerciale. Il corpus televisivo è solo per la ricerca secondo un accordo che vieta la cooperazione con partner commerciali[7]. Un prodotto commerciale addestrato su uno qualsiasi di essi opererebbe al di fuori dei termini dei propri dati. Non esiste alcun meccanismo pubblicato che consenta a un acquirente di scoprire se ciò sia avvenuto, e un acquirente che legga la documentazione di un fornitore raramente troverà una dichiarazione sulla provenienza del corpus sufficientemente dettagliata da escluderlo.
Cosa eredita un acquirente
Un'istituzione che distribuisce un sistema di intelligenza artificiale per la lingua dei segni ne eredita il corpus. Eredita il consenso che è stato o non è stato ottenuto, i termini di licenza che sono stati o non sono stati rispettati, il registro degli interpreti o gli errori degli apprendisti, e l'impossibilità del ritiro. Li eredita in una forma specifica: le persone sorde a cui il sistema è destinato osserveranno un sistema produrre volti appresi da membri della propria stessa comunità, e alcune di queste persone saranno in grado di riconoscere di chi sia quel volto.
Ecco perché la questione del corpus precede quella dell'accuratezza. Un sistema il cui output è eccellente ma il cui corpus è stato prelevato senza consenso non ha risolto un problema di governance; lo ha monetizzato. Un sistema il cui corpus è pienamente tracciato ma il cui output è scadente è quantomeno un sistema i cui fallimenti possono essere discussi con le persone che esso riguarda. La Convenzione sui diritti delle persone con disabilità richiede agli Stati Parti, nello sviluppare politiche che riguardano le persone con disabilità, di “consultarsi strettamente e coinvolgere attivamente” tali persone attraverso le loro organizzazioni rappresentative[12]. Un corpus assemblato da persone a cui non è mai stato chiesto nulla è l'esempio più evidente disponibile di una tecnologia sviluppata senza tale coinvolgimento, e un'istituzione che lo acquista non sta consultando nessuno a sua volta.
Le risposte non saranno, nella maggior parte dei casi, rassicuranti. Questo non è un motivo per lasciare le domande inespresse. È il motivo per porle prima della firma, quando le risposte possono ancora cambiare la decisione, piuttosto che dopo la distribuzione, quando cambiano solo la responsabilità. Gli acquirenti che le pongono per primi stabiliranno i termini a cui il resto del mercato sarà infine tenuto a rispondere.
Riferimenti
- Bragg, D., Caselli, N., Hochgesang, J. A., Huenerfauth, M., Katz-Hernandez, L., Koller, O., Kushalnagar, R., Vogler, C., and Ladner, R. E. (2021). The FATE landscape of sign language AI datasets: An interdisciplinary perspective. ACM Transactions on Accessible Computing, 14(2), Article 7. https://doi.org/10.1145/3436996
- Li, D., Rodriguez, C., Yu, X., and Li, H. (2020). Word-level deep sign language recognition from video: A new large-scale dataset and methods comparison. Proceedings of the IEEE/CVF Winter Conference on Applications of Computer Vision (WACV). Dataset documentation and licence statement at https://github.com/dxli94/WLASL
- Neidle, C., and Ballard, C. (2022). Why alternative gloss labels will increase the value of the WLASL dataset. American Sign Language Linguistic Research Project Report No. 21, Boston University. https://www.bu.edu/asllrp/rpt21/asllrp21.pdf
- Uthus, D., Tanzer, G., and Georg, M. (2023). YouTube-ASL: A large-scale, open-domain American Sign Language-English parallel corpus. Advances in Neural Information Processing Systems 36, Datasets and Benchmarks Track.
- Albanie, S., Varol, G., Momeni, L., Bull, H., Afouras, T., Chowdhury, H., Fox, N., Woll, B., Cooper, R., McParland, A., and Zisserman, A. (2021). BBC-Oxford British Sign Language dataset. arXiv:2111.03635. Dataset terms at https://www.robots.ox.ac.uk/~vgg/data/bobsl/
- Camgöz, N. C., Hadfield, S., Koller, O., Ney, H., and Bowden, R. (2018). Neural sign language translation. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 7784-7793.
- De Sisto, M., Vandeghinste, V., Egea Gómez, S., De Coster, M., Shterionov, D., and Saggion, H. (2022). Challenges with sign language datasets for sign language recognition and translation. Proceedings of the Thirteenth Language Resources and Evaluation Conference (LREC 2022), 2478-2487. https://aclanthology.org/2022.lrec-1.264
- Duarte, A., Palaskar, S., Ventura, L., Ghadiyaram, D., DeHaan, K., Metze, F., Torres, J., and Giró-i-Nieto, X. (2021). How2Sign: A large-scale multimodal dataset for continuous American Sign Language. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). Licence statement at https://how2sign.github.io/
- Desai, A., De Meulder, M., Hochgesang, J. A., Kocab, A., and Lu, A. X. (2024). Systemic biases in sign language AI research: A Deaf-led call to reevaluate research agendas. arXiv:2403.02563.
- Illinois Biometric Information Privacy Act, 740 ILCS 14/10 (definitions) and 14/15(b) (consent). https://law.justia.com/codes/illinois/chapter-740/act-740-ilcs-14/
- Information Commissioner’s Office (United Kingdom). What is special category data? Guidance on Article 9 UK GDPR, biometric data. https://ico.org.uk/for-organisations/uk-gdpr-guidance-and-resources/lawful-basis/special-category-data/what-is-special-category-data/
- United Nations (2006). Convention on the Rights of Persons with Disabilities, Article 4(3). https://www.un.org/development/desa/disabilities/convention-on-the-rights-of-persons-with-disabilities.html