
Chaque système d'IA en langue des signes est construit à partir d'enregistrements de personnes en train de signer. De qui était ce signe, ce que ces personnes ont accepté, ce qu'elles ont été payées, et si elles peuvent un jour reprendre leur visage, sont des questions auxquelles le marché n'a pas répondu et que la plupart des acheteurs n'ont pas posées.
Le visage, c'est la donnée
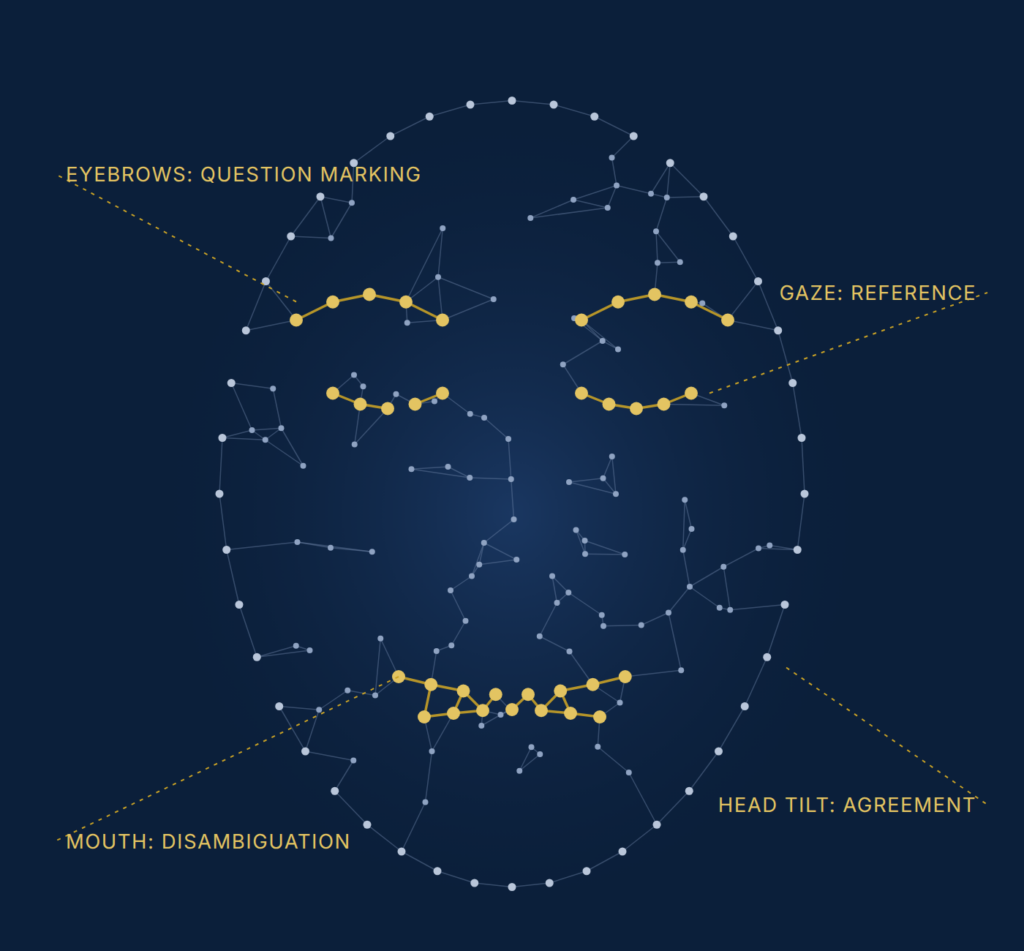
Dans les technologies du langage parlé et écrit, les données d'entraînement et la personne peuvent généralement être dissociées. Une phrase peut être dépouillée de son auteur. Une voix peut être transformée jusqu'à devenir méconnaissable tandis que les mots demeurent. Les langues des signes ne permettent pas cette dissociation, car la langue se produit sur le corps. Les mains portent le lexique, mais la grammaire se distribue sur le visage : la position des sourcils marque les questions, les mouvements de la bouche désambiguïsent les signes, l'inclinaison de la tête et la direction du regard établissent la référence et l'accord. Un enregistrement d'un signeur au visage flouté n'est pas un échantillon linguistique désidentifié. C'en est un corrompu.
Cela a une conséquence que la littérature sur l'apprentissage automatique reconnaît depuis un certain temps et que la littérature sur les marchés publics n'a pas encore intégrée. Un corpus en langue des signes est, nécessairement, une collection d'enregistrements identifiables de personnes précises. La communauté des signeurs de tout pays est restreinte, et l'examen interdisciplinaire des ensembles de données d'IA en langue des signes mené par Bragg et ses collègues a observé qu'« en raison de la petite taille de la communauté sourde, il est possible d'identifier personnellement les signeurs dans les vidéos »[1]. Un modèle entraîné sur un tel corpus a appris à partir des visages de ces personnes. Si le système génère du signe, il a appris à produire des visages qui leur ressemblent. La question de savoir de qui provient le signe qui a construit le système n'est donc pas une question abstraite d'éthique des données. C'est une question portant sur des individus nommés, identifiables, dont l'image fait désormais partie d'un produit.
Un enregistrement d'un signeur au visage flouté n'est pas un échantillon linguistique désidentifié. C'en est un corrompu.
D'où viennent les corpus
Les corpus documentés qui sous-tendent la recherche publiée en reconnaissance et génération de langue des signes ont été constitués selon un petit nombre de méthodes, et la méthode de constitution détermine presque tout ce qui suit.
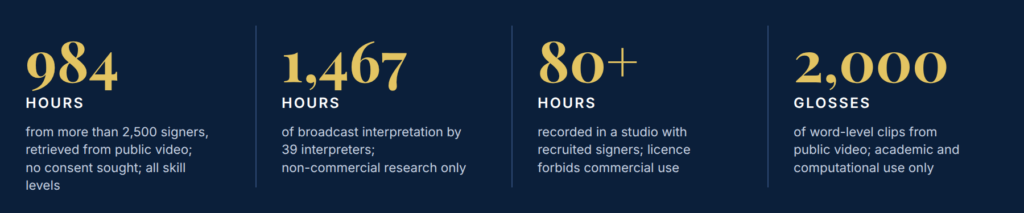
La première méthode est la collecte à partir de vidéos publiques. Un ensemble de données largement utilisé, au niveau du mot, en langue des signes américaine a été compilé en téléchargeant des vidéos depuis YouTube et des sites d'enseignement de la langue des signes, organisées en environ deux mille glosses, et diffusé sous l'accord d'usage computationnel des données de Microsoft, avec la mention que l'ensemble des données « est destiné uniquement à un usage académique et computationnel » et qu'« aucun usage commercial n'est autorisé »[2]. Sa documentation enregistre un identifiant de signeur pour chaque clip mais ne contient aucune déclaration sur le consentement des signeurs, leur maîtrise de la langue ou leur connaissance du fait que leur vidéo avait été collectée. Un examen linguistique ultérieur a révélé que ses étiquettes de glose en anglais étaient « incohérentes de manière généralisée », le même signe étant étiqueté par des mots différents et le même mot étant appliqué à des signes différents[3]. Un corpus plus vaste publié en 2023 a rassemblé 984 heures de séquences provenant de plus de 2 500 signeurs en récupérant des vidéos YouTube publiques étiquetées comme contenu en langue des signes ; ses auteurs expliquent avoir inclus « des vidéos de tous niveaux de compétence et de tous styles de signe, du moment qu'elles étaient compréhensibles pour un utilisateur de l'ASL », qu'ils ne diffusent que des identifiants vidéo et non les vidéos elles-mêmes, et que la voie de retrait pour un créateur consiste à rendre la vidéo privée ou à la supprimer[4].
La deuxième méthode est l'interprétation diffusée. Le plus grand corpus en langue des signes britannique se compose d'environ 1 467 heures de programmes de la BBC comportant un interprète à l'écran, produit par 39 interprètes au total, et disponible pour la recherche non commerciale dans le cadre d'un accord de partage de données avec le diffuseur, qui oblige les chercheurs à supprimer des parties ou la totalité de l'ensemble de données sur instruction[5]. Le corpus allemand des bulletins météo, qui a servi de base aux premiers résultats de traduction neuronale en langue des signes, a été constitué de la même manière, à partir d'interprètes télévisés rendant le script d'un présentateur entendant[6]. Ces interprètes ont été payés pour interpréter une émission diffusée. Ils n'ont pas été payés pour fournir un corpus d'entraînement, et la langue qu'ils ont produite est une interprétation sous contrainte de temps à partir d'une source parlée. De Sisto et ses collègues avertissent que l'utilisation de « données non natives et/ou interprétées pour entraîner des systèmes de traduction censés pouvoir reconnaître, et générer, une langue authentique/native spontanée conduira à des traductions moins naturelles et très probablement inexactes », et décrivent le résultat comme une forme de translationese dans laquelle le flux signé « sera toujours d'une manière ou d'une autre affecté par la langue source parlée »[7].
La troisième méthode est l'enregistrement en studio avec des signeurs recrutés. L'exemple le plus connu est un corpus de plus de quatre-vingts heures d'ASL continu enregistré dans des conditions contrôlées avec des participants consentants, diffusé sous une licence Creative Commons qui interdit tout usage commercial[8]. C'est le modèle qui ressemble le plus à une éthique de recherche ordinaire : des participants recrutés, informés, rémunérés en tant que participants de recherche, et enregistrés dans un but déclaré. C'est aussi la manière la plus coûteuse de constituer un corpus, ce qui explique qu'elle en produise les plus petits.
La quatrième méthode est la collecte privée par les entreprises qui vendent des produits d'IA en langue des signes. C'est la méthode qui compte le plus pour un acheteur, et c'est celle sur laquelle le moins d'informations sont documentées. Les données d'entraînement propres à un fournisseur n'apparaissent dans aucun article de présentation d'ensemble de données. Elles n'ont aucune page de licence. Qu'elles aient été extraites, achetées, enregistrées avec des signeurs embauchés, apportées par des utilisateurs du produit, ou assemblées à partir des corpus de recherche publics décrits ci-dessus, avec ou sans égard pour leurs restrictions d'usage, cela n'est pas visible de l'extérieur de l'entreprise.
Quatre questions auxquelles répond la méthode de constitution
Mis côte à côte, les corpus documentés répondent à quatre questions de quatre manières différentes, et ces différences constituent l'ensemble du sujet.
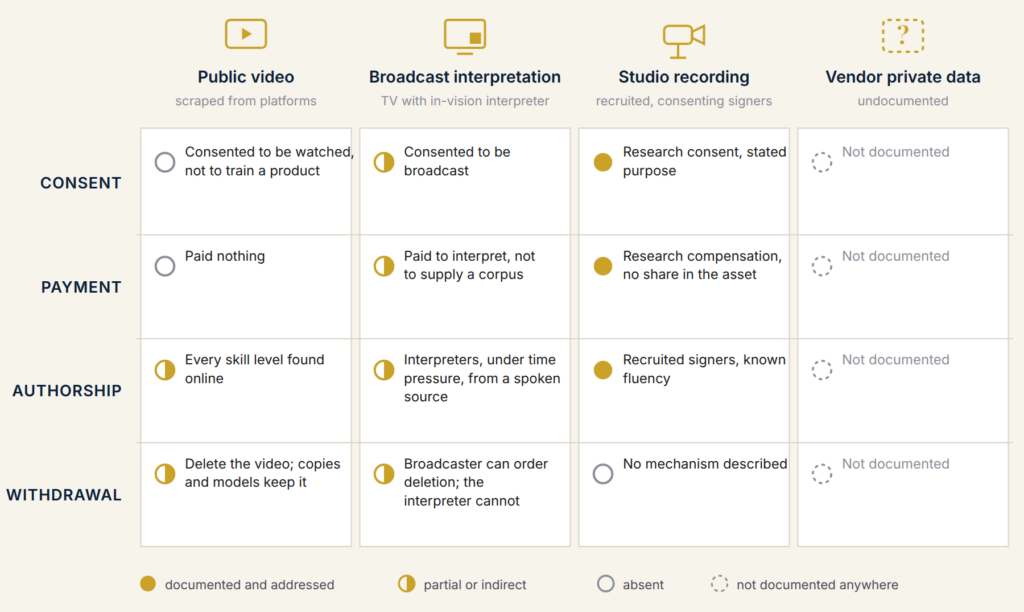
La première question est celle du consentement. Une personne ayant téléversé une vidéo pour enseigner un signe a consenti à être regardée. Que ce consentement s'étende à être décomposée en caractéristiques d'entraînement pour un produit commercial est une question à laquelle les conditions d'utilisation de la plateforme répondent en faveur de la plateforme, et presque certainement pas selon la propre compréhension de la personne. Les interprètes diffusés ont consenti à être diffusés. Les participants en studio ont consenti à la recherche. Dans aucun des cas documentés en dehors des corpus de studio n'existe de preuve que le signeur ait été interrogé sur la possibilité que son signe serve à construire une machine qui signe.
Dans aucun des cas documentés en dehors des corpus de studio n'existe de preuve que le signeur ait été interrogé sur la possibilité que son signe serve à construire une machine qui signe.
La deuxième question est celle de la rémunération. Les personnes dont le signe a produit les plus grands corpus n'ont rien été payées pour cela, car les corpus ont été constitués à partir d'un travail qu'elles avaient déjà accompli pour d'autres raisons ou pour aucune raison du tout. Les interprètes ont été payés par les diffuseurs pour interpréter. Les personnes ayant téléversé du contenu n'ont été payées par personne. Seuls les participants en studio ont reçu quelque chose, et ils ont reçu une compensation de recherche, non une part d'un actif commercial. Bragg et ses collègues notent que les accords sur les données « peuvent préciser une compensation pour l'usage, décrire les usages autorisés des données » et fixer des limites de durée d'utilisation[1]. Les corpus publics documentés ne le font pas, car ils n'ont pas été construits sur des accords avec les signeurs. Ils ont été construits sur des accords avec des plateformes et des diffuseurs.
La troisième question est celle de la paternité, au sens de la langue que le système a apprise. Un corpus d'interprètes a appris l'interprétation, avec son décalage, son ombre de langue source et son registre professionnel. Un corpus regroupant tous les niveaux de compétence trouvés sur une plateforme vidéo a appris un mélange de signe natif, de signe en langue seconde et de signe d'apprenant, pondéré selon ce que les gens ont bien voulu téléverser. Bragg et ses collègues notent que « la majorité des utilisateurs de langue des signes ne sont peut-être pas sourds, et les signeurs de langue première ne constituent qu'une petite fraction des utilisateurs pour la plupart des langues des signes »[1], et un corpus constitué à partir de vidéos publiques hérite de cette proportion. Un examen mené par des personnes sourdes de 101 articles sur l'IA en langue des signes a révélé un domaine « dominé par des chercheurs entendants ne signant pas » et « conduit par ce que les chercheurs entendants jugent le plus commode ou perçoivent comme important »[9]. La commodité est aussi ce qui détermine quel corpus est utilisé. La question de savoir quelle langue un système parle se règle, en pratique, par la facilité avec laquelle les enregistrements ont pu être obtenus.
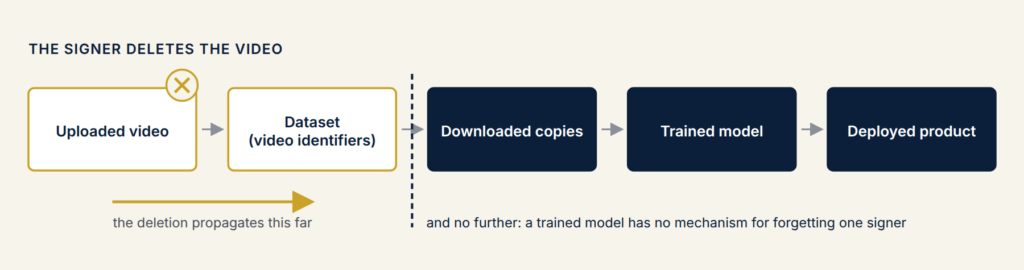
La quatrième question est celle du retrait. Une personne qui apparaît dans un ensemble de données constitué à partir de vidéos publiques peut supprimer la vidéo. Si l'ensemble de données a été diffusé sous forme d'identifiants vidéo, la suppression se propage à quiconque n'a pas déjà téléchargé le clip. Elle ne se propage pas à ceux qui l'ont fait, et elle ne se propage pas dans un modèle qui a été entraîné avant la suppression. Le corpus de diffusion est le seul cas documenté comportant une obligation contractuelle de suppression, et cette obligation va du diffuseur au chercheur, non de l'interprète à qui que ce soit. Un modèle entraîné ne dispose d'aucun mécanisme permettant d'oublier un signeur en particulier. Le retrait, au sens où une personne l'entendrait, n'est disponible nulle part dans le paysage documenté une fois l'entraînement effectué.
La faille du droit
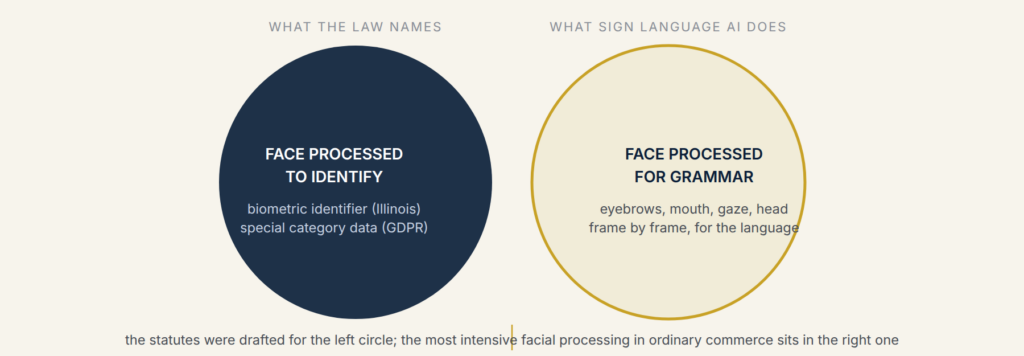
Les lecteurs qui présument que les visages sont protégés par le droit de la vie privée biométrique devraient examiner la manière dont ce droit est rédigé. L'Illinois Biometric Information Privacy Act, la plus stricte des lois américaines, définit un identifiant biométrique comme « un scan de la rétine ou de l'iris, une empreinte digitale, une empreinte vocale, ou un scan de la géométrie de la main ou du visage », et exclut expressément les photographies de cette définition ; elle exige une autorisation écrite avant qu'une entité privée ne collecte un tel identifiant[10]. Selon les régimes européen et britannique de protection des données, les données biométriques deviennent des données à caractère particulier lorsqu'elles sont traitées « aux fins d'identifier de manière unique une personne physique », et le régulateur britannique précise explicitement que les photographies et vidéos ordinaires de personnes « ne constituent pas automatiquement des données biométriques même si vous les utilisez à des fins d'identification » ; le statut de catégorie particulière s'attache lorsqu'un traitement technique spécifique produit un gabarit destiné à la correspondance[11].
Un modèle en langue des signes traite le visage avec un niveau de détail extraordinaire. Il extrait la position des sourcils, la forme de la bouche, la direction du regard et le mouvement de la tête image par image, car ces caractéristiques constituent la grammaire. Mais il ne les traite pas pour identifier le signeur. Il les traite pour apprendre la langue. À la lettre des textes, c'est exactement la finalité pour laquelle les catégories biométriques n'ont pas été prévues. Le traitement informatique le plus intensif du visage d'une personne qui existe dans le commerce ordinaire peut donc se situer en dehors des protections rédigées en pensant aux visages, parce que les rédacteurs présupposaient qu'un visage ne serait traité que pour dire à qui il appartient. Il ne s'agit pas d'une conclusion juridique établie, et Novara Consulting Group ne formule aucun avis juridique concernant une quelconque juridiction. C'est une observation selon laquelle les catégories ne correspondent pas, et qu'un fournisseur interrogé sur le fait de savoir si son corpus constitue des « données biométriques » pourrait répondre non en toute bonne foi tout en détenant des milliers d'heures de visages sourds identifiables.
Les licences sont une question distincte et plus simple. Le corpus au niveau du mot n'autorise qu'un usage académique et computationnel. Le corpus de studio est non commercial. Le corpus de diffusion est réservé à la recherche dans le cadre d'un accord interdisant toute coopération avec des partenaires commerciaux[7]. Un produit commercial entraîné sur l'un quelconque de ces corpus fonctionnerait en dehors des conditions de ses données. Aucun mécanisme publié ne permet à un acheteur de savoir si cela s'est produit, et un acheteur lisant la documentation d'un fournisseur trouvera rarement une déclaration de provenance du corpus suffisamment détaillée pour l'exclure.
Ce dont hérite un acheteur
Une institution qui déploie un système d'IA en langue des signes hérite de son corpus. Elle hérite du consentement qui a été ou n'a pas été obtenu, des conditions de licence qui ont été ou n'ont pas été respectées, du registre des interprètes ou des erreurs des apprenants, et de l'impossibilité du retrait. Elle en hérite sous une forme particulière : les personnes sourdes qu'elle sert observeront un système produire des visages appris à partir de membres de leur propre communauté, et certaines d'entre elles seront capables de reconnaître de qui il s'agit.
C'est pourquoi la question du corpus précède celle de la précision. Un système dont la production est excellente mais dont le corpus a été pris sans consentement n'a pas résolu un problème de gouvernance ; il en a monétisé un. Un système dont le corpus est entièrement documenté mais dont la production est médiocre est au moins un système dont les échecs peuvent être discutés avec les personnes qu'il concerne. La Convention relative aux droits des personnes handicapées exige des États parties, lors de l'élaboration de politiques concernant les personnes handicapées, de « consulter étroitement et faire activement participer » ces personnes par l'intermédiaire de leurs organisations représentatives[12]. Un corpus constitué à partir de personnes à qui l'on n'a jamais rien demandé est l'exemple le plus manifeste d'une technologie développée sans cette participation, et une institution qui l'achète ne consulte personne non plus.
Les réponses ne seront, dans la plupart des cas, pas rassurantes. Ce n'est pas une raison pour ne pas poser les questions. C'est la raison de les poser avant la signature, quand les réponses peuvent encore changer la décision, plutôt qu'après le déploiement, quand elles ne changent plus que la responsabilité. Les acheteurs qui posent ces questions en premier fixeront les conditions auxquelles le reste du marché devra tôt ou tard répondre.
Références
- Bragg, D., Caselli, N., Hochgesang, J. A., Huenerfauth, M., Katz-Hernandez, L., Koller, O., Kushalnagar, R., Vogler, C., and Ladner, R. E. (2021). The FATE landscape of sign language AI datasets: An interdisciplinary perspective. ACM Transactions on Accessible Computing, 14(2), Article 7. https://doi.org/10.1145/3436996
- Li, D., Rodriguez, C., Yu, X., and Li, H. (2020). Word-level deep sign language recognition from video: A new large-scale dataset and methods comparison. Proceedings of the IEEE/CVF Winter Conference on Applications of Computer Vision (WACV). Dataset documentation and licence statement at https://github.com/dxli94/WLASL
- Neidle, C., and Ballard, C. (2022). Why alternative gloss labels will increase the value of the WLASL dataset. American Sign Language Linguistic Research Project Report No. 21, Boston University. https://www.bu.edu/asllrp/rpt21/asllrp21.pdf
- Uthus, D., Tanzer, G., and Georg, M. (2023). YouTube-ASL: A large-scale, open-domain American Sign Language-English parallel corpus. Advances in Neural Information Processing Systems 36, Datasets and Benchmarks Track.
- Albanie, S., Varol, G., Momeni, L., Bull, H., Afouras, T., Chowdhury, H., Fox, N., Woll, B., Cooper, R., McParland, A., and Zisserman, A. (2021). BBC-Oxford British Sign Language dataset. arXiv:2111.03635. Dataset terms at https://www.robots.ox.ac.uk/~vgg/data/bobsl/
- Camgöz, N. C., Hadfield, S., Koller, O., Ney, H., and Bowden, R. (2018). Neural sign language translation. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 7784-7793.
- De Sisto, M., Vandeghinste, V., Egea Gómez, S., De Coster, M., Shterionov, D., and Saggion, H. (2022). Challenges with sign language datasets for sign language recognition and translation. Proceedings of the Thirteenth Language Resources and Evaluation Conference (LREC 2022), 2478-2487. https://aclanthology.org/2022.lrec-1.264
- Duarte, A., Palaskar, S., Ventura, L., Ghadiyaram, D., DeHaan, K., Metze, F., Torres, J., and Giró-i-Nieto, X. (2021). How2Sign: A large-scale multimodal dataset for continuous American Sign Language. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). Licence statement at https://how2sign.github.io/
- Desai, A., De Meulder, M., Hochgesang, J. A., Kocab, A., and Lu, A. X. (2024). Systemic biases in sign language AI research: A Deaf-led call to reevaluate research agendas. arXiv:2403.02563.
- Illinois Biometric Information Privacy Act, 740 ILCS 14/10 (definitions) and 14/15(b) (consent). https://law.justia.com/codes/illinois/chapter-740/act-740-ilcs-14/
- Information Commissioner’s Office (United Kingdom). What is special category data? Guidance on Article 9 UK GDPR, biometric data. https://ico.org.uk/for-organisations/uk-gdpr-guidance-and-resources/lawful-basis/special-category-data/what-is-special-category-data/
- United Nations (2006). Convention on the Rights of Persons with Disabilities, Article 4(3). https://www.un.org/development/desa/disabilities/convention-on-the-rights-of-persons-with-disabilities.html