
Todo sistema de IA de lenguaje de señas se construye a partir de grabaciones de personas que hacen señas. De quién era ese lenguaje de señas, qué acordaron, cuánto se les pagó y si alguna vez pueden recuperar sus rostros son preguntas que el mercado no ha respondido y que la mayoría de los compradores no ha formulado.
El rostro es el dato
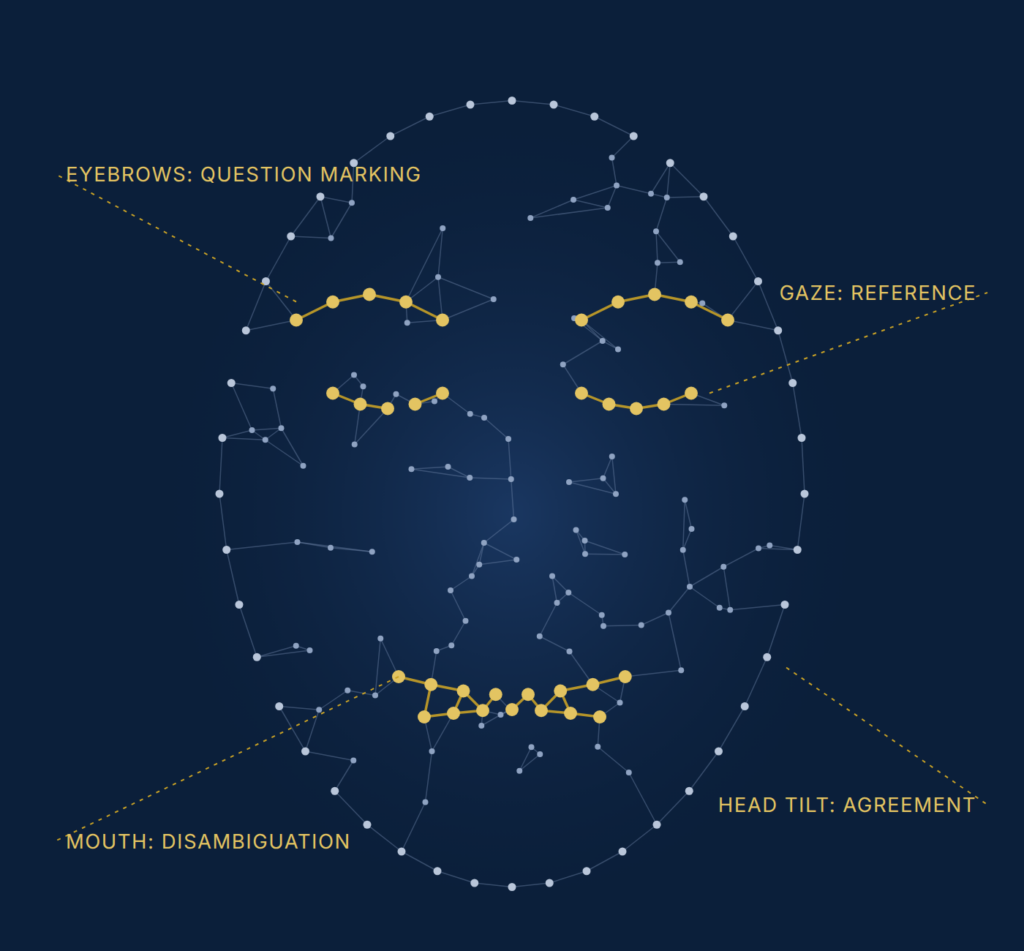
En la tecnología de lenguaje hablado y escrito, los datos de entrenamiento y la persona por lo general pueden separarse. Una frase puede despojarse de su autor. Una voz puede transformarse hasta que el hablante resulte irreconocible y las palabras permanezcan. Las lenguas de señas no permiten esta separación, porque la lengua se produce sobre el cuerpo. Las manos portan el léxico, pero la gramática se distribuye por el rostro: la posición de las cejas marca las preguntas, los patrones de la boca desambiguan señas, la inclinación de la cabeza y la dirección de la mirada establecen referencia y concordancia. Una grabación de un firmante con el rostro difuminado no es una muestra de lenguaje anonimizada. Es una muestra corrupta.
Esto tiene una consecuencia que la literatura de aprendizaje automático ha reconocido desde hace tiempo y que la literatura de adquisiciones no ha reconocido. Un corpus de lengua de señas es, necesariamente, una colección de grabaciones identificables de personas específicas. La comunidad de firmantes en cualquier país es pequeña, y la revisión interdisciplinaria de conjuntos de datos de IA de lenguaje de señas dirigida por Bragg y colegas observó que “debido al pequeño tamaño de la comunidad Deaf, puede ser posible identificar personalmente a los firmantes en los videos”[1]. Un modelo entrenado con dicho corpus ha aprendido de los rostros de estas personas. Si el sistema genera señas, ha aprendido a producir rostros que se parecen a los suyos. La pregunta de a quién pertenecía el lenguaje de señas que construyó el sistema no es, por lo tanto, una pregunta abstracta de ética de datos. Es una pregunta sobre personas nombradas y localizables cuya semejanza ahora forma parte de un producto.
Una grabación de un firmante con el rostro difuminado no es una muestra de lenguaje anonimizada. Es una muestra corrupta.
De dónde provienen los corpus
Los corpus documentados que sustentan la investigación publicada en reconocimiento y generación de lenguaje de señas se ensamblaron mediante un pequeño número de métodos, y el método de ensamblaje determina casi todo lo que sigue.
El primer método es la recopilación a partir de video público. Un conjunto de datos ampliamente utilizado de nivel de palabra en lengua de señas americana se compiló descargando videos de YouTube y sitios de enseñanza de lengua de señas, organizados en aproximadamente dos mil glosas, y publicado bajo el Acuerdo de Uso Computacional de Datos de Microsoft con la declaración de que todos los datos “están destinados únicamente a uso académico y computacional” y que “no se permite ningún uso comercial”[2]. Su documentación registra un identificador de firmante para cada clip, pero no contiene ninguna declaración sobre el consentimiento, la fluidez o el conocimiento de los firmantes de que su video había sido recopilado. Un examen lingüístico posterior encontró que sus etiquetas de glosa en inglés eran “omnipresente[mente]” inconsistentes, con la misma seña etiquetada con palabras distintas y la misma palabra aplicada a señas distintas[3]. Un corpus más grande publicado en 2023 reunió 984 horas de metraje de más de 2,500 firmantes recuperando videos públicos de YouTube etiquetados como contenido de lengua de señas; sus autores explican que incluyeron “videos de todos los niveles de habilidad y estilos de señas, siempre que fueran comprensibles para un usuario de ASL”, que solo publican identificadores de video en lugar de los videos mismos, y que la vía de retiro para un creador es hacer privado el video o eliminarlo[4].
El segundo método es la interpretación en transmisiones. El corpus más grande de lengua de señas británica consiste en aproximadamente 1,467 horas de programas de la BBC con un intérprete en pantalla, producidas por 39 intérpretes en total, y está disponible para investigación no comercial bajo un acuerdo de intercambio de datos con la emisora que obliga a los investigadores a eliminar partes o la totalidad del conjunto de datos si así se les indica[5]. El corpus alemán de pronósticos meteorológicos que fundamentó los primeros resultados de traducción neuronal de lengua de señas se construyó del mismo modo, a partir de intérpretes de televisión que traducían el guion de un presentador oyente[6]. Estos intérpretes fueron pagados por interpretar una transmisión. No se les pagó por proporcionar un corpus de entrenamiento, y el lenguaje que produjeron es interpretación bajo presión de tiempo a partir de una fuente hablada. De Sisto y colegas advierten que usar “datos no nativos y/o interpretados para entrenar sistemas de traducción que deberían ser capaces de reconocer y generar lenguaje espontáneo autóntico/nativo conducirá a traducciones menos naturales y muy probablemente inexactas”, y describen el resultado como una forma de lenguaje traducido en la que el flujo de señas “siempre estará de alguna manera afectado por la lengua hablada de origen”[7].
El tercer método es la grabación en estudio con firmantes reclutados. El ejemplo más conocido es un corpus de más de ochenta horas de lengua de señas americana continua, grabado en condiciones controladas con participantes que dieron su consentimiento, publicado bajo una licencia Creative Commons que prohíbe el uso comercial[8]. Este es el modelo que más se parece a la ética de investigación ordinaria: participantes reclutados, informados, compensados como participantes de investigación, y grabados con un propósito declarado. También es la forma más costosa de construir un corpus, razón por la cual produce los más pequeños.
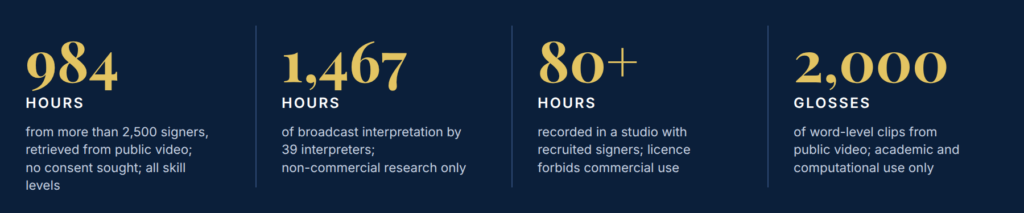
El cuarto método es la recopilación privada por parte de las empresas que venden productos de IA de lenguaje de señas. Este es el método que más importa para un comprador, y es aquel sobre el cual menos se documenta. Los datos de entrenamiento propios de un proveedor no aparecen en ningún artículo sobre conjuntos de datos. No tienen página de licencia. Si fueron extraídos, comprados, grabados con firmantes contratados, aportados por usuarios del producto, o ensamblados a partir de los corpus públicos de investigación descritos arriba, con o sin consideración de sus restricciones de uso, no es visible desde fuera de la empresa.
Cuatro preguntas que responde el método de ensamblaje
Puestos uno junto a otro, los corpus documentados responden cuatro preguntas de cuatro maneras distintas, y las diferencias son el tema central.
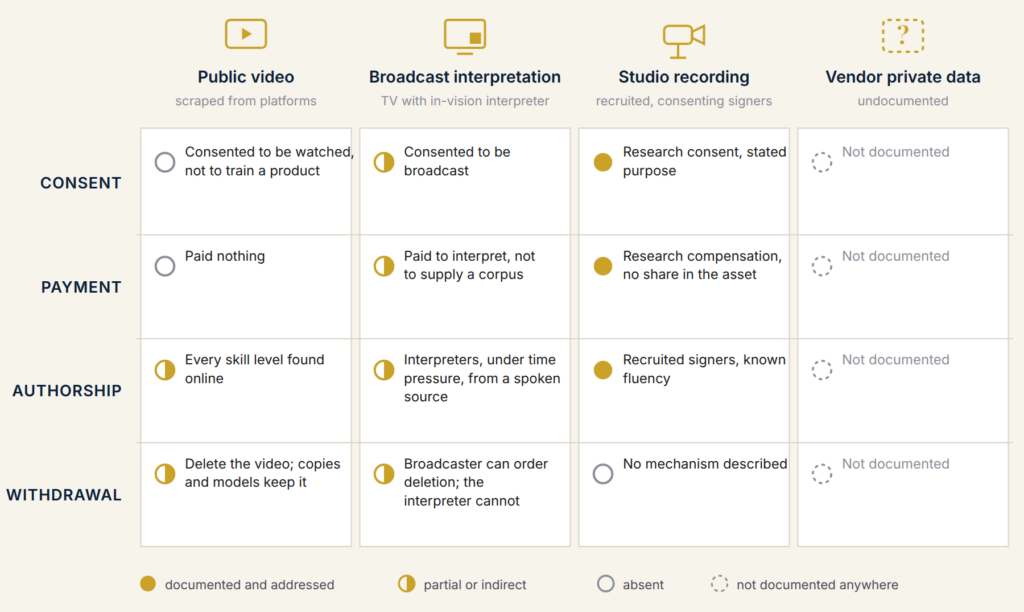
La primera pregunta es el consentimiento. Una persona que subió un video para enseñar una seña consintió en ser observada. Si ese consentimiento se extiende a ser descompuesta en características de entrenamiento para un producto comercial es una pregunta que los términos de servicio de la plataforma responden a favor de la plataforma, y que la comprensión propia de la persona casi con certeza no comparte. Los intérpretes de transmisión consintieron en ser transmitidos. Los participantes de estudio consintieron en investigación. En ninguno de los casos documentados fuera de los corpus de estudio hay evidencia de que se le preguntara al firmante si su lenguaje de señas podía usarse para construir una máquina que hace señas.
En ninguno de los casos documentados fuera de los corpus de estudio hay evidencia de que se le preguntara al firmante si su lenguaje de señas podía usarse para construir una máquina que hace señas.
La segunda pregunta es el pago. Las personas cuyo lenguaje de señas produjo los corpus más grandes no recibieron nada por ello, porque los corpus se construyeron a partir de trabajo que ya habían hecho por otras razones o sin razón alguna. A los intérpretes se les pagó por parte de las emisoras por interpretar. A quienes subieron los videos no les pagó nadie. Solo los participantes de estudio recibieron algo, y recibieron compensación de investigación, no una participación en un activo comercial. Bragg y colegas señalan que los acuerdos de datos “pueden especificar compensación por uso, describir los usos permitidos de los datos” y establecer límites de tiempo para el uso[1]. Los corpus públicos documentados no hacen esto porque no se construyeron sobre acuerdos con firmantes. Se construyeron sobre acuerdos con plataformas y emisoras.
La tercera pregunta es la autoría, en el sentido de a quién pertenece el lenguaje que el sistema ha aprendido. Un corpus de intérpretes ha aprendido interpretación, con su retraso, su sombra de la lengua fuente y su registro profesional. Un corpus de todos los niveles de habilidad encontrados en una plataforma de video ha aprendido una mezcla de lenguaje de señas nativo, lenguaje de señas de segunda lengua y lenguaje de señas de aprendiz, ponderado según lo que la gente resultó subir. Bragg y colegas señalan que “la mayoría de los usuarios de lengua de señas puede no ser Deaf, y los firmantes de primera lengua constituyen solo una pequeña fracción de los usuarios para la mayoría de las lenguas de señas”[1], y un corpus ensamblado a partir de video público hereda esa proporción. Una revisión liderada por personas Deaf de 101 artículos de IA de lenguaje de señas encontró que el campo está “dominado por investigadores oyentes que no hacen señas” y “guiado por lo que las decisiones son más convenientes o se perciben como importantes para los investigadores oyentes”[9]. La conveniencia también es lo que decide qué corpus se usa. La pregunta de a quién pertenece el lenguaje que habla un sistema se resuelve, en la práctica, por cuáles grabaciones fueron más fáciles de obtener.
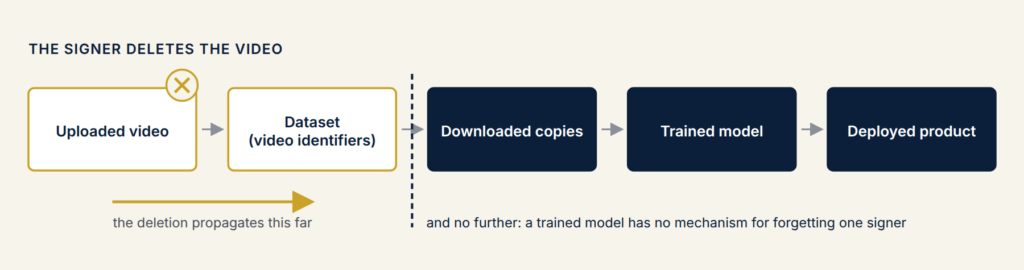
La cuarta pregunta es el retiro. Una persona que aparece en un conjunto de datos ensamblado a partir de video público puede eliminar el video. Si el conjunto de datos se distribuyó como identificadores de video, la eliminación se propaga a cualquiera que aún no haya descargado el clip. No se propaga a quien ya lo hizo, ni se propaga a un modelo que fue entrenado antes de la eliminación. El corpus de transmisión es el único caso documentado con una obligación contractual de eliminación, y esa obligación va de la emisora al investigador, no del intérprete a nadie. Un modelo entrenado no tiene ningún mecanismo para olvidar a un firmante. El retiro, en el sentido que una persona lo entendería, no está disponible en ninguna parte del panorama documentado una vez que ha ocurrido el entrenamiento.
El vacío en la ley
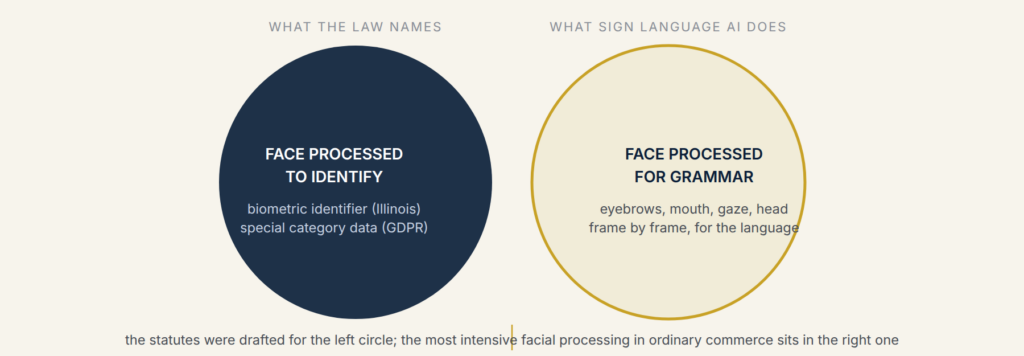
Los lectores que asumen que los rostros están protegidos por la ley de privacidad biométrica deberían examinar cómo está redactada esa ley. La Ley de Privacidad de Información Biométrica de Illinois, la más estricta de los estatutos estadounidenses, define un identificador biométrico como “un escaneo de retina o iris, huella digital, huella de voz, o escaneo de la geometría de la mano o el rostro” y excluye expresamente las fotografías de la definición; requiere una autorización por escrito antes de que una entidad privada recopile tal identificador[10]. Bajo los regímenes europeo y del Reino Unido de protección de datos, los datos biométricos se convierten en datos de categoría especial cuando se procesan “con el propósito de identificar de forma única a una persona física”, y el regulador del Reino Unido es explícito en que las fotografías y videos ordinarios de personas “no son automáticamente datos biométricos incluso si se usan con fines de identificación”; la condición de categoría especial se aplica cuando un procesamiento técnico específico produce una plantilla para comparación[11].
Un modelo de lenguaje de señas procesa el rostro con un detalle extraordinario. Extrae la posición de las cejas, la forma de la boca, la dirección de la mirada y el movimiento de la cabeza cuadro por cuadro, porque esas características son la gramática. Pero no los procesa para identificar al firmante. Los procesa para aprender el lenguaje. Según la letra de los estatutos, ese es exactamente el propósito para el cual no se redactaron las categorías biométricas. El procesamiento computacional más intensivo del rostro de una persona que existe en el comercio ordinario puede, por lo tanto, situarse fuera de las protecciones que se redactaron pensando en los rostros, porque los redactores asumieron que un rostro solo se procesaría para decir a quién pertenece. Esta no es una conclusión legal establecida, y Novara Consulting Group no ofrece opinión legal sobre ninguna jurisdicción. Es una observación de que las categorías no se ajustan, y que a un proveedor al que se le pregunte si su corpus es “datos biométricos” puede responder que no de perfecta buena fe mientras posee miles de horas de rostros Deaf identificables.
Las licencias son un asunto separado y más simple. El corpus a nivel de palabra permite únicamente uso académico y computacional. El corpus de estudio es no comercial. El corpus de transmisión es solo para investigación bajo un acuerdo que prohíbe la cooperación con socios comerciales[7]. Un producto comercial entrenado con cualquiera de ellos estaría operando fuera de los términos de sus datos. No existe ningún mecanismo publicado para que un comprador averigüe si eso ha ocurrido, y un comprador que lea la documentación del proveedor rara vez encontrará una declaración de procedencia del corpus lo suficientemente detallada para descartarlo.
Lo que hereda un comprador
Una institución que despliega un sistema de IA de lenguaje de señas hereda su corpus. Hereda el consentimiento que se obtuvo o no, los términos de licencia que se respetaron o no, el registro de los intérpretes o los errores de los aprendices, y la imposibilidad de retiro. Los hereda en una forma específica: las personas Deaf a quienes sirve estarán observando un sistema producir rostros aprendidos de miembros de su propia comunidad, y algunas de esas personas podrán reconocer de quién es ese rostro.
Por esto la pregunta del corpus precede a la pregunta de la precisión. Un sistema cuya salida es excelente pero cuyo corpus se obtuvo sin consentimiento no ha resuelto un problema de gobernanza; lo ha monetizado. Un sistema cuyo corpus está plenamente documentado pero cuya salida es deficiente es, al menos, un sistema cuyos fallos pueden discutirse con las personas a las que afecta. La Convención sobre los Derechos de las Personas con Discapacidad exige a los Estados Partes, al desarrollar políticas que concierne a las personas con discapacidad, “celebrar consultas estrechas y colaborar activamente” con ellas a través de sus organizaciones representativas[12]. Un corpus ensamblado a partir de personas a quienes nunca se les preguntó es el ejemplo más claro disponible de una tecnología desarrollada sin esa participación, y una institución que lo compra tampoco está consultando a nadie.
Las respuestas no serán, en la mayoría de los casos, tranquilizadoras. Eso no es razón para dejar las preguntas sin formular. Es la razón para formularlas antes de la firma, cuando las respuestas aún cambian la decisión, en lugar de después del despliegue, cuando solo cambian la responsabilidad. Los compradores que preguntan primero establecerán los términos bajo los cuales el resto del mercado eventualmente se verá obligado a responder.
Referencias
- Bragg, D., Caselli, N., Hochgesang, J. A., Huenerfauth, M., Katz-Hernandez, L., Koller, O., Kushalnagar, R., Vogler, C., and Ladner, R. E. (2021). The FATE landscape of sign language AI datasets: An interdisciplinary perspective. ACM Transactions on Accessible Computing, 14(2), Article 7. https://doi.org/10.1145/3436996
- Li, D., Rodriguez, C., Yu, X., and Li, H. (2020). Word-level deep sign language recognition from video: A new large-scale dataset and methods comparison. Proceedings of the IEEE/CVF Winter Conference on Applications of Computer Vision (WACV). Dataset documentation and licence statement at https://github.com/dxli94/WLASL
- Neidle, C., and Ballard, C. (2022). Why alternative gloss labels will increase the value of the WLASL dataset. American Sign Language Linguistic Research Project Report No. 21, Boston University. https://www.bu.edu/asllrp/rpt21/asllrp21.pdf
- Uthus, D., Tanzer, G., and Georg, M. (2023). YouTube-ASL: A large-scale, open-domain American Sign Language-English parallel corpus. Advances in Neural Information Processing Systems 36, Datasets and Benchmarks Track.
- Albanie, S., Varol, G., Momeni, L., Bull, H., Afouras, T., Chowdhury, H., Fox, N., Woll, B., Cooper, R., McParland, A., and Zisserman, A. (2021). BBC-Oxford British Sign Language dataset. arXiv:2111.03635. Dataset terms at https://www.robots.ox.ac.uk/~vgg/data/bobsl/
- Camgöz, N. C., Hadfield, S., Koller, O., Ney, H., and Bowden, R. (2018). Neural sign language translation. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 7784-7793.
- De Sisto, M., Vandeghinste, V., Egea Gómez, S., De Coster, M., Shterionov, D., and Saggion, H. (2022). Challenges with sign language datasets for sign language recognition and translation. Proceedings of the Thirteenth Language Resources and Evaluation Conference (LREC 2022), 2478-2487. https://aclanthology.org/2022.lrec-1.264
- Duarte, A., Palaskar, S., Ventura, L., Ghadiyaram, D., DeHaan, K., Metze, F., Torres, J., and Giró-i-Nieto, X. (2021). How2Sign: A large-scale multimodal dataset for continuous American Sign Language. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). Licence statement at https://how2sign.github.io/
- Desai, A., De Meulder, M., Hochgesang, J. A., Kocab, A., and Lu, A. X. (2024). Systemic biases in sign language AI research: A Deaf-led call to reevaluate research agendas. arXiv:2403.02563.
- Illinois Biometric Information Privacy Act, 740 ILCS 14/10 (definitions) and 14/15(b) (consent). https://law.justia.com/codes/illinois/chapter-740/act-740-ilcs-14/
- Information Commissioner’s Office (United Kingdom). What is special category data? Guidance on Article 9 UK GDPR, biometric data. https://ico.org.uk/for-organisations/uk-gdpr-guidance-and-resources/lawful-basis/special-category-data/what-is-special-category-data/
- United Nations (2006). Convention on the Rights of Persons with Disabilities, Article 4(3). https://www.un.org/development/desa/disabilities/convention-on-the-rights-of-persons-with-disabilities.html