
每一个手语人工智能系统都建立在人们打手语的录像基础之上。这些录像里的人是谁、他们同意了什么、他们得到了什么报酬、他们是否能够收回自己的面孔——这些问题,市场尚未作答,而大多数买家甚至从未提出过。
面孔即数据
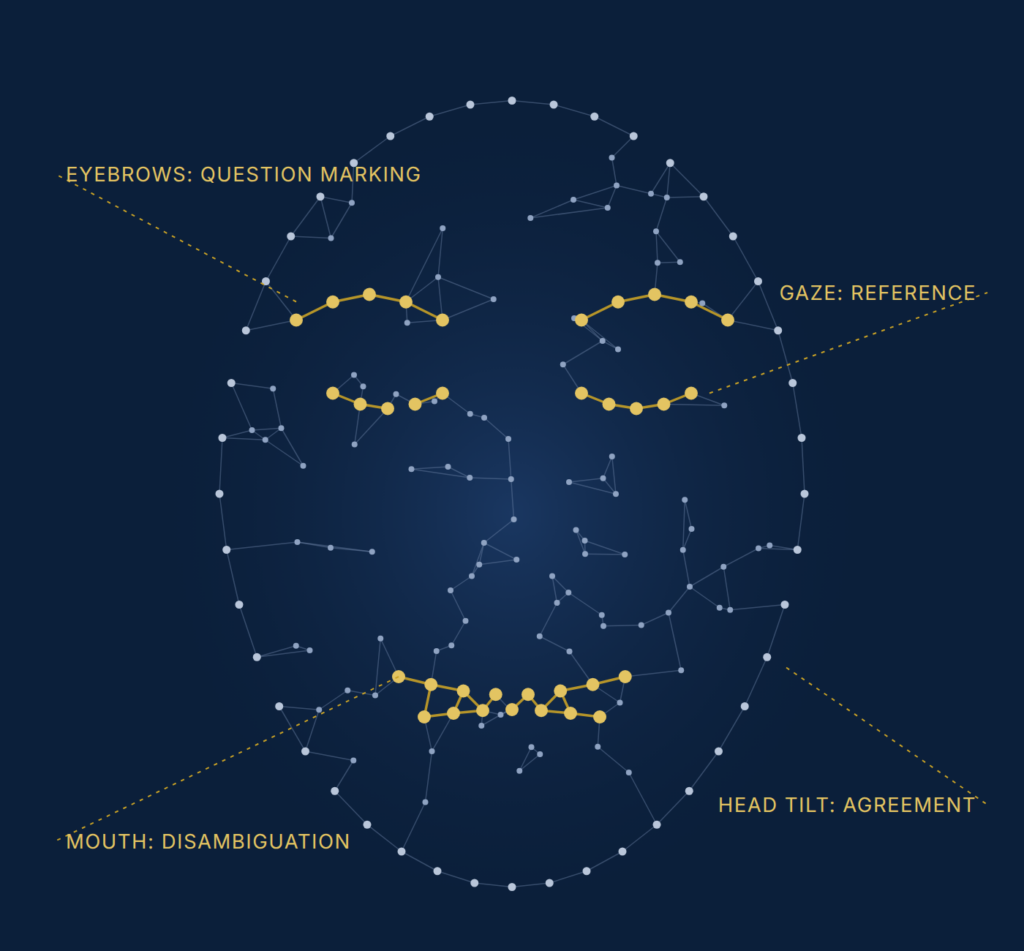
在口语和书面语言技术中,训练数据与个人通常是可以分离的。一句话可以剥离其作者身份。一段声音可以被转换到说话者无法被辨认的程度,而话语本身依然完整。手语不允许这种分离,因为这种语言是通过身体来产生的。手部承载词汇,但语法则分布在面部:眉毛的位置标记疑问句,嘴型消除手势的歧义,头部倾斜和眼神注视确立指称和一致关系。一段面部被打了马赛克的打手语者录像,并不是一个去标识化的语言样本,而是一个被破坏了的样本。
这带来了一个后果,机器学习文献早已认识到,而采购文献却尚未认识到。手语语料库必然是特定个人的可识别录像的集合。任何国家的手语社群规模都很小,由Bragg及其同事领导的手语人工智能数据集跨学科评审指出,“由于聋人社群规模较小,视频中的打手语者有可能被辨认出身份”[1]。一个在此类语料库上训练出来的模型,已经从这些人的面孔中学习。如果该系统能生成手语,那么它已经学会了生成与他们相似的面孔。因此,系统究竟是由谁的手语构建而成,并不是一个抽象的数据伦理问题,而是关于具名的、可查找的个人的问题——他们的容貌如今已成为产品的一部分。
一段面部被打了马赛克的打手语者录像,并不是一个去标识化的语言样本,而是一个被破坏了的样本。
语料库从何而来
支撑已发表的手语识别与生成研究的、有据可查的语料库,是通过少数几种方式汇编而成的,而汇编方法几乎决定了后续的一切。
第一种方法是从公开视频中收集。一个广泛使用的词级美国手语数据集,是通过从YouTube和手语教学网站下载视频编制而成的,整理为大约两千个词汇标注,并依据微软的数据计算用途协议发布,该协议声明所有数据“仅供学术和计算用途”,且“不允许任何商业用途”[2]。其文档为每段视频记录了打手语者的标识符,但没有任何关于打手语者同意、流利程度或是否知晓其视频已被收集的说明。后续的语言学检验发现,其英语词汇标注“普遍存在”不一致的问题,同一个手势被标注为不同的词,同一个词又被用于标注不同的手势[3]。2023年发布的一个更大规模的语料库,通过检索被标记为手语内容的公开YouTube视频,收集了来自2500多名打手语者的984小时素材;其作者解释说,他们纳入了“各种熟练程度和打手语风格的视频,只要对美国手语使用者而言是可理解的”,他们只发布视频标识符而非视频本身,而创作者撤回内容的途径是将视频设为私密或删除视频[4]。
第二种方法是广播口译。规模最大的英国手语语料库由约1467小时的BBC节目组成,这些节目带有画面内手语译员,共由39名译员完成,依据与广播机构签订的数据共享协议,可供非商业性研究使用,该协议要求研究人员在被要求时删除数据集的部分或全部内容[5]。奠定首批神经网络手语翻译成果基础的德国天气预报广播语料库,也是以同样方式构建的,即由电视手语译员翻译健听主持人的稿件[6]。这些译员是被雇来做广播口译的,而不是被雇来提供训练语料库的,他们所产生的语言是在时间压力下、源自口语文本的口译。De Sisto及其同事警告说,使用“非母语和/或口译数据来训练那些本应能够识别和生成自然、地道母语的翻译系统,将导致翻译结果不那么自然,而且极有可能不准确”,并将这种结果描述为一种翻译腔,即手语流“总会在某种程度上受到源头口语的影响”[7]。
第三种方法是在录音棚中由招募的打手语者录制。最著名的例子是一个超过八十小时的连续美国手语语料库,它是在受控条件下由同意参与的参与者录制而成,并依据一份禁止商业用途的知识共享许可协议发布[8]。这种模式最接近普通的研究伦理:招募参与者、告知情况、作为研究参与者给予补偿,并为既定目的进行录制。这也是构建语料库中成本最高的方式,这正是为什么由此产生的语料库规模最小。
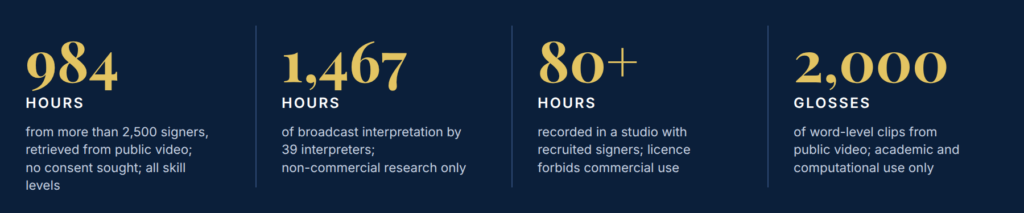
第四种方法是由销售手语人工智能产品的公司私下收集。这是对买家而言最重要的方法,也是记录最少的一种。供应商自有的训练数据不会出现在数据集论文中,没有许可页面。它究竟是被抓取的、购买的、由雇佣的打手语者录制的、由产品用户贡献的,还是从上述公开研究语料库中汇编而来的(无论是否顾及其使用限制),外界从公司外部都无法看到。
汇编方法回答的四个问题
将这些有据可查的语料库并列比较,可以看到它们以四种不同的方式回答了四个问题,而这些差异正是全部问题所在。
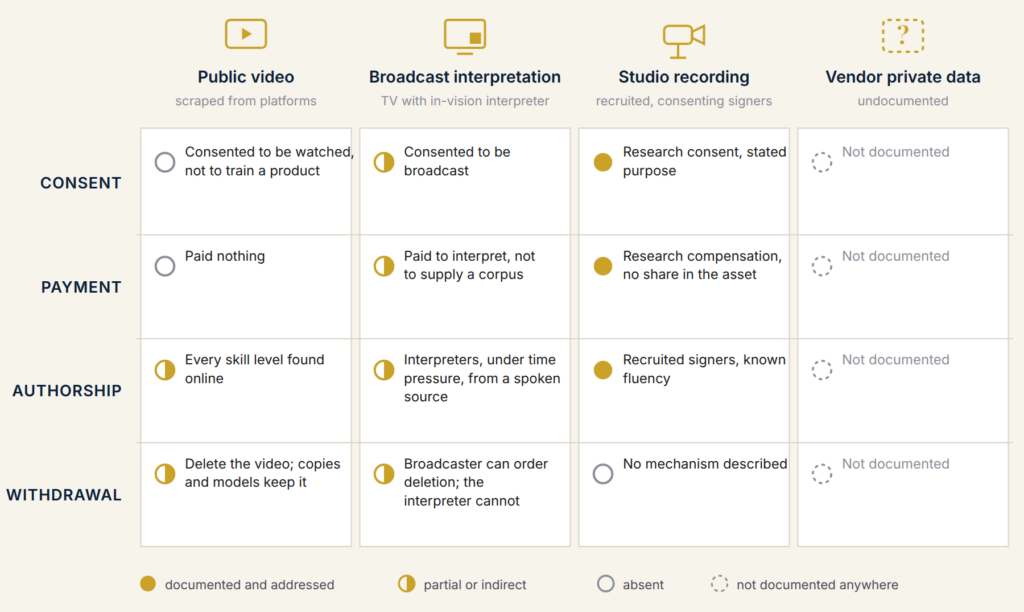
第一个问题是同意。一个上传视频来教授某个手势的人,同意的是被观看。这种同意是否延伸到被拆解为商业产品的训练特征,是一个由平台服务条款以有利于平台的方式作答、而当事人自己的理解几乎肯定不会认同的问题。广播译员同意的是被播出。录音棚参与者同意的是参与研究。在录音棚语料库之外的所有有据可查的案例中,没有证据表明打手语者曾被问及其手语是否可以被用来构建一台会打手语的机器。
在录音棚语料库之外的所有有据可查的案例中,没有证据表明打手语者曾被问及其手语是否可以被用来构建一台会打手语的机器。
第二个问题是报酬。产生了最大规模语料库的那些人,其手语没有获得任何报酬,因为这些语料库是由他们出于其他目的、或根本没有目的而已经完成的工作构建而成的。译员由广播机构支付口译费用。上传者则无人支付。只有录音棚参与者获得了报酬,而且他们获得的是研究补偿,而非商业资产中的分成。Bragg及其同事指出,数据协议“可能会规定使用报酬、说明数据的允许用途”,并对使用设定时限[1]。有据可查的公开语料库并未做到这一点,因为它们并非建立在与打手语者的协议之上,而是建立在与平台和广播机构的协议之上。
第三个问题是署名权,即从系统学到的是谁的语言这层意义上的署名权。一个由译员构成的语料库,学到的是口译,带有其固有的延迟、源语言的影子和职业化的语域。一个来自视频平台上各种熟练程度的语料库,学到的是母语打手语、二语打手语和学习者打手语的混合体,其权重取决于人们碰巧上传了什么。Bragg及其同事指出,“大多数手语使用者可能并非聋人,而对大多数手语而言,母语打手语者只占使用者中的一小部分”[1],而由公开视频汇编而成的语料库继承了这种比例。一项对101篇手语人工智能论文的、由聋人主导的评审发现,该领域“由不打手语的健听研究者主导”,并且“由对健听研究者而言最方便或被认为最重要的决策所驱动”[9]。实际上,方便与否也决定了哪个语料库会被使用。系统所说的是谁的语言这一问题,在实践中是由哪些录像最容易获取来决定的。
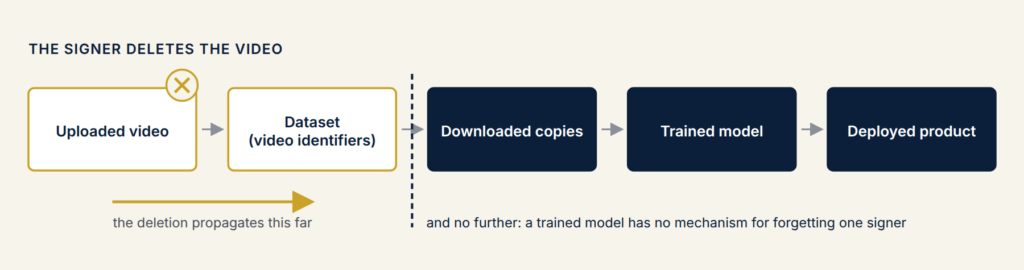
第四个问题是撤回。出现在由公开视频汇编而成的数据集中的人,可以删除该视频。如果该数据集是以视频标识符的形式发布的,那么删除操作会传播给尚未下载该片段的任何人,但不会传播给已经下载过的人,也不会传播进入在删除之前就已训练完成的模型。广播语料库是唯一有据可查的、附带合同删除义务的案例,而且该义务是从广播机构流向研究者,而非从译员流向任何人。一个已训练完成的模型没有任何机制可以忘记某一位打手语者。就一个人所理解的意义而言,在训练已经发生之后,撤回在整个有据可查的格局中根本不可获得。
法律中的空白
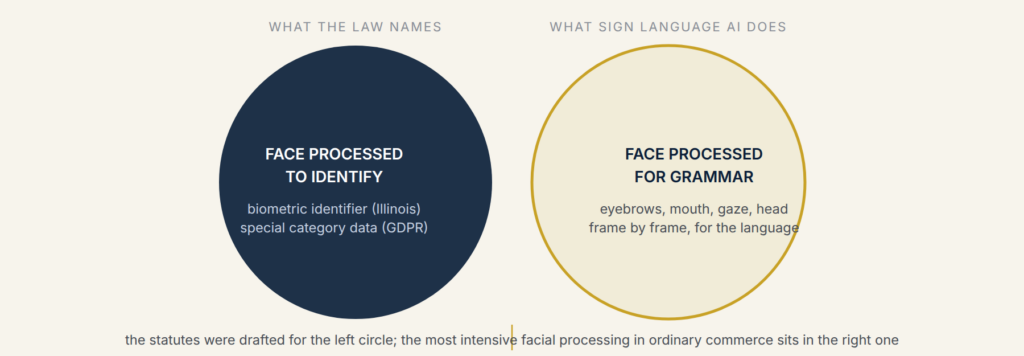
那些以为面孔受到生物识别隐私法保护的读者,应当看看这类法律是如何起草的。伊利诺伊州《生物识别信息隐私法》是美国各州法规中最严格的一部,它将生物识别标识符定义为“视网膜或虹膜扫描、指纹、声纹,或手部或面部几何形状扫描”,并明确将照片排除在该定义之外;该法要求私人实体在收集此类标识符之前必须获得书面同意[10]。在欧洲和英国的数据保护制度下,只有当生物识别数据的处理“目的是唯一识别某一自然人”时,它才成为特殊类别数据;英国的监管机构明确指出,人们的普通照片和视频“即便被用于识别目的,也不会自动成为生物识别数据”;只有当特定的技术处理产生了一个用于比对的模板时,特殊类别的地位才会附加其上[11]。
手语模型对面部进行了极其精细的处理。它逐帧提取眉毛位置、嘴型、注视方向和头部动作,因为这些特征就是语法。但它处理这些特征并非为了识别打手语者,而是为了学习这门语言。就法规字面而言,这恰恰是生物识别类别当初未曾为之设立的用途。因此,普通商业活动中对一个人的面部进行的最密集的计算处理,可能恰恰落在了那些为面孔量身定制的保护范围之外,因为起草者当初假定面孔只会被处理来判断它属于谁。这并非一个已经定论的法律结论,Novara Consulting Group对任何司法管辖区都不提供法律意见。这只是一个观察:现有类别并不适用于此,而一个被问及其语料库是否属于“生物识别数据”的供应商,即便手中握有数千小时可识别身份的聋人面孔,也完全有可能出于真诚而给出否定的答案。
许可协议是另一个更简单的问题。词级语料库仅允许学术和计算用途。录音棚语料库禁止商业用途。广播语料库依据一份禁止与商业伙伴合作的协议,仅限研究用途[7]。任何以这些语料库训练而成的商业产品,都是在其数据条款之外运作的。目前不存在任何已公布的机制,能让买家查清此事是否已经发生;而阅读供应商文档的买家,也很少能找到详尽到足以排除这种可能性的语料库来源说明。
买家继承了什么
一个部署手语人工智能系统的机构,继承的是其语料库。它继承了或曾经获得、或从未获得的同意,继承了或曾经被遵守、或从未被遵守的许可条款,继承了译员的语域或学习者的错误,还继承了撤回的不可能性。它以一种特定的形式继承这一切:它所服务的聋人将会目睹一个系统生成从自己社群成员那里学来的面孔,而其中一些人将能够辨认出那是谁的面孔。
这正是为什么语料库问题先于准确性问题。一个输出效果出色、但语料库未经同意而获取的系统,并没有解决治理问题,而是将治理问题变现了。一个语料库来源完全清楚、但输出效果不佳的系统,至少是一个其失误可以与受影响的人进行讨论的系统。《残疾人权利公约》要求缔约国在制定涉及残疾人的政策时,“通过残疾人的代表组织与其进行密切协商,并积极使其参与”[12]。一个由从未被问及意见的人汇编而成的语料库,是缺乏这种参与而开发出来的技术的最明显例证,而购买这种技术的机构,同样也没有征询任何人的意见。
在大多数情况下,答案都不会令人安心。但这不是不去提问的理由。恰恰相反,这正是应当在签约之前提出这些问题的理由——那时答案仍能改变决定,而不是等到部署之后,那时答案只能改变责任归属。率先提问的买家,将为整个市场最终必须作答的条件定下基调。
参考文献
- Bragg, D., Caselli, N., Hochgesang, J. A., Huenerfauth, M., Katz-Hernandez, L., Koller, O., Kushalnagar, R., Vogler, C., and Ladner, R. E. (2021). The FATE landscape of sign language AI datasets: An interdisciplinary perspective. ACM Transactions on Accessible Computing, 14(2), Article 7. https://doi.org/10.1145/3436996
- Li, D., Rodriguez, C., Yu, X., and Li, H. (2020). Word-level deep sign language recognition from video: A new large-scale dataset and methods comparison. Proceedings of the IEEE/CVF Winter Conference on Applications of Computer Vision (WACV). Dataset documentation and licence statement at https://github.com/dxli94/WLASL
- Neidle, C., and Ballard, C. (2022). Why alternative gloss labels will increase the value of the WLASL dataset. American Sign Language Linguistic Research Project Report No. 21, Boston University. https://www.bu.edu/asllrp/rpt21/asllrp21.pdf
- Uthus, D., Tanzer, G., and Georg, M. (2023). YouTube-ASL: A large-scale, open-domain American Sign Language-English parallel corpus. Advances in Neural Information Processing Systems 36, Datasets and Benchmarks Track.
- Albanie, S., Varol, G., Momeni, L., Bull, H., Afouras, T., Chowdhury, H., Fox, N., Woll, B., Cooper, R., McParland, A., and Zisserman, A. (2021). BBC-Oxford British Sign Language dataset. arXiv:2111.03635. Dataset terms at https://www.robots.ox.ac.uk/~vgg/data/bobsl/
- Camgöz, N. C., Hadfield, S., Koller, O., Ney, H., and Bowden, R. (2018). Neural sign language translation. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 7784-7793.
- De Sisto, M., Vandeghinste, V., Egea Gómez, S., De Coster, M., Shterionov, D., and Saggion, H. (2022). Challenges with sign language datasets for sign language recognition and translation. Proceedings of the Thirteenth Language Resources and Evaluation Conference (LREC 2022), 2478-2487. https://aclanthology.org/2022.lrec-1.264
- Duarte, A., Palaskar, S., Ventura, L., Ghadiyaram, D., DeHaan, K., Metze, F., Torres, J., and Giró-i-Nieto, X. (2021). How2Sign: A large-scale multimodal dataset for continuous American Sign Language. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). Licence statement at https://how2sign.github.io/
- Desai, A., De Meulder, M., Hochgesang, J. A., Kocab, A., and Lu, A. X. (2024). Systemic biases in sign language AI research: A Deaf-led call to reevaluate research agendas. arXiv:2403.02563.
- Illinois Biometric Information Privacy Act, 740 ILCS 14/10 (definitions) and 14/15(b) (consent). https://law.justia.com/codes/illinois/chapter-740/act-740-ilcs-14/
- Information Commissioner’s Office (United Kingdom). What is special category data? Guidance on Article 9 UK GDPR, biometric data. https://ico.org.uk/for-organisations/uk-gdpr-guidance-and-resources/lawful-basis/special-category-data/what-is-special-category-data/
- United Nations (2006). Convention on the Rights of Persons with Disabilities, Article 4(3). https://www.un.org/development/desa/disabilities/convention-on-the-rights-of-persons-with-disabilities.html