
Todo sistema de IA de língua gestual é construído a partir de gravações de pessoas a gesticular. De quem era a gestualização, o que essas pessoas aceitaram, quanto lhes foi pago e se alguma vez poderão retirar os seus rostos são questões que o mercado não respondeu e que a maioria dos compradores não colocou.
O rosto é o dado
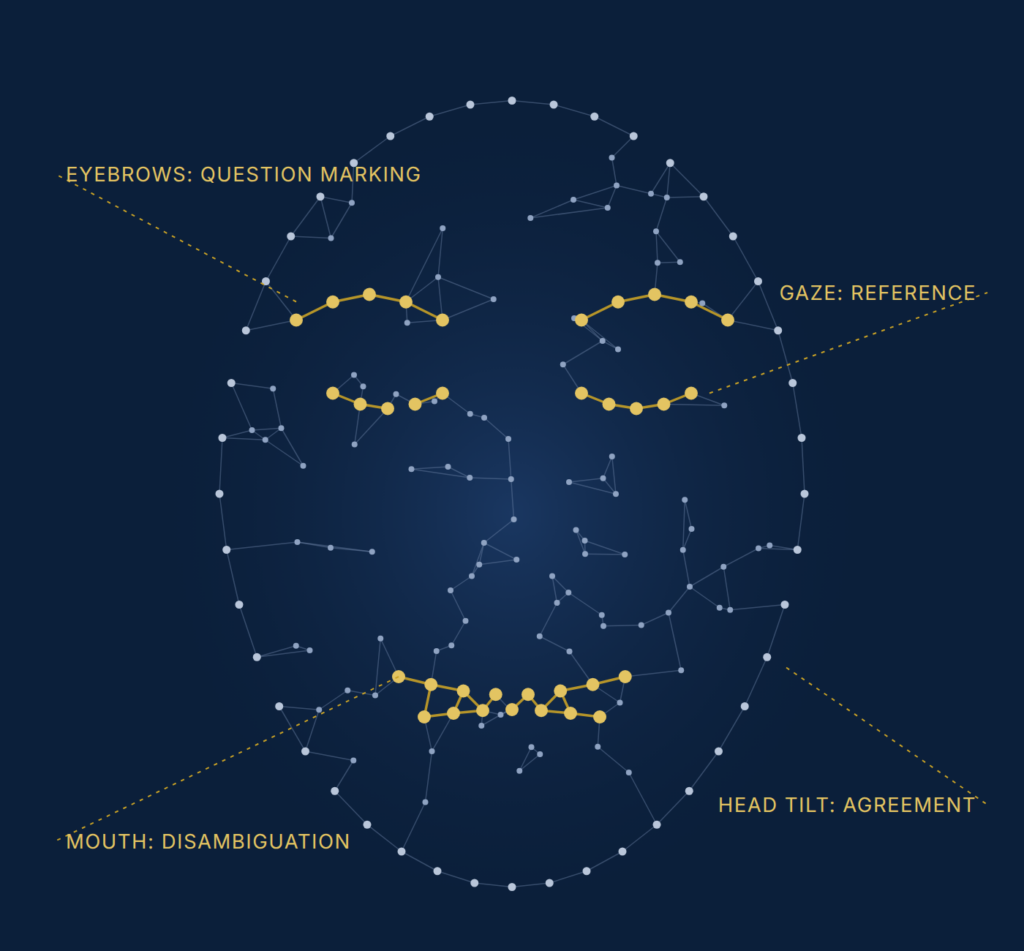
Na tecnologia de linguagem falada e escrita, os dados de treino e a pessoa podem geralmente ser separados. Uma frase pode ser despojada do seu autor. Uma voz pode ser transformada até o locutor se tornar irreconhecível e as palavras permanecerem. As línguas gestuais não permitem esta separação, porque a língua é produzida no corpo. As mãos transportam o léxico, mas a gramática está distribuída pelo rosto: a posição das sobrancelhas marca perguntas, os padrões da boca desambiguam sinais, a inclinação da cabeça e a direção do olhar estabelecem referência e concordância. Uma gravação de um gesticulador com o rosto desfocado não é uma amostra linguística desidentificada. É uma amostra corrompida.
Isto tem uma consequência que a literatura de aprendizagem automática reconhece há algum tempo e a literatura de contratação pública não. Um corpus de língua gestual é, necessariamente, uma coleção de gravações identificáveis de pessoas específicas. A comunidade gestuante em qualquer país é pequena, e a revisão interdisciplinar de conjuntos de dados de IA de língua gestual liderada por Bragg e colegas observou que “devido ao pequeno tamanho da comunidade surda, pode ser possível identificar pessoalmente os gesticuladores nos vídeos”[1]. Um modelo treinado com esse corpus aprendeu a partir dos rostos destas pessoas. Se o sistema gera gesticulação, aprendeu a produzir rostos que se assemelham aos delas. A questão de quem gesticulou para construir o sistema não é, portanto, uma questão abstrata de ética de dados. É uma questão sobre indivíduos nomeados e localizáveis cuja semelhança faz agora parte de um produto.
Uma gravação de um gesticulador com o rosto desfocado não é uma amostra linguística desidentificada. É uma amostra corrompida.
De onde vêm os corpora
Os corpora documentados que sustentam a investigação publicada em reconhecimento e geração de língua gestual foram reunidos por um pequeno número de métodos, e o método de reunião determina quase tudo o que se segue.
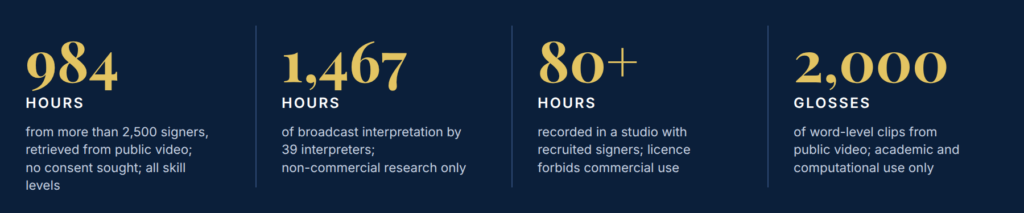
O primeiro método é a recolha a partir de vídeo público. Um conjunto de dados de Língua Gestual Americana ao nível da palavra, amplamente utilizado, foi compilado através do descarregamento de vídeos do YouTube e de sítios de ensino de língua gestual, organizado em cerca de duas mil glosas, e disponibilizado ao abrigo do Acordo de Uso Computacional de Dados da Microsoft com a declaração de que todos os dados “se destinam apenas a uso académico e computacional” e que “não é permitido qualquer uso comercial”[2]. A sua documentação regista um identificador de gesticulador para cada clipe, mas não contém qualquer declaração sobre o consentimento, a fluência ou a consciência dos gesticuladores de que o seu vídeo tinha sido recolhido. Um exame linguístico posterior constatou que as suas etiquetas de glosa em inglês eram “de forma generalizada” inconsistentes, com o mesmo sinal rotulado por palavras diferentes e a mesma palavra aplicada a sinais diferentes[3]. Um corpus maior, lançado em 2023, reuniu 984 horas de filmagens de mais de 2.500 gesticuladores através da recolha de vídeos públicos do YouTube identificados como conteúdo de língua gestual; os seus autores explicam que incluíram “vídeos de todos os níveis de competência e estilos de gesticulação, desde que fossem compreensíveis para um utilizador de ASL”, que apenas disponibilizam identificadores de vídeo e não os próprios vídeos, e que a via de retirada para um criador é tornar o vídeo privado ou eliminá-lo[4].
O segundo método é a interpretação televisiva. O maior corpus de Língua Gestual Britânica consiste em cerca de 1.467 horas de programas da BBC com um intérprete em vídeo, produzidos por 39 intérpretes no total, e está disponível para investigação não comercial ao abrigo de um acordo de partilha de dados com a estação de televisão que obriga os investigadores a eliminar partes ou a totalidade do conjunto de dados se tal for instruído[5]. O corpus alemão de previsões meteorológicas televisivas, que serviu de base aos primeiros resultados de tradução neuronal de língua gestual, foi construído da mesma forma, a partir de intérpretes de televisão a traduzir o texto de um apresentador ouvinte[6]. Estes intérpretes foram pagos para interpretar uma emissão. Não foram pagos para fornecer um corpus de treino, e a língua que produziram é interpretação sob pressão de tempo a partir de uma fonte falada. De Sisto e colegas alertam que usar “dados não nativos e/ou interpretados para treinar sistemas de tradução que deveriam ser capazes de reconhecer, e gerar, língua autêntica/nativa espontânea conduzirá a traduções menos naturais e muito provavelmente imprecisas”, descrevendo o resultado como uma forma de tradutês em que o fluxo gestual “será sempre de alguma forma afetado pela língua falada de origem”[7].
O terceiro método é a gravação em estúdio com gesticuladores recrutados. O exemplo mais conhecido é um corpus com mais de oitenta horas de Língua Gestual Americana contínua, gravado em condições controladas com participantes consentidos e disponibilizado ao abrigo de uma licença Creative Commons que proíbe o uso comercial[8]. Este é o modelo que mais se assemelha à ética de investigação comum: participantes recrutados, informados, remunerados como participantes de investigação e gravados para um fim declarado. É também a forma mais cara de construir um corpus, razão pela qual produz os mais pequenos.
O quarto método é a recolha privada pelas empresas que vendem produtos de IA de língua gestual. Este é o método que mais importa a um comprador, e é aquele sobre o qual menos está documentado. Os dados de treino próprios de um fornecedor não aparecem em nenhum artigo de conjunto de dados. Não têm página de licença. Se foram extraídos, comprados, gravados com gesticuladores contratados, contribuídos por utilizadores do produto, ou reunidos a partir dos corpora de investigação pública acima descritos, com ou sem respeito pelas suas restrições de uso, não é visível a partir de fora da empresa.
Quatro perguntas que o método de reunião responde
Postos lado a lado, os corpora documentados respondem a quatro perguntas de quatro formas diferentes, e as diferenças são todo o assunto.
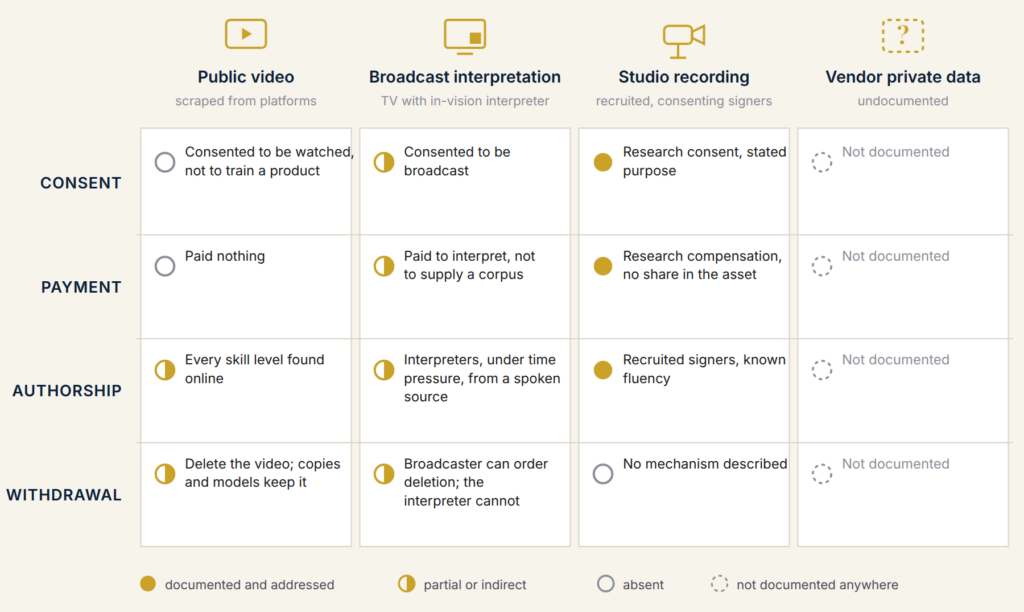
A primeira pergunta é o consentimento. Uma pessoa que carregou um vídeo para ensinar um sinal consentiu em ser vista. Se esse consentimento se estende a ser decomposta em características de treino para um produto comercial é uma questão que os termos de serviço da plataforma respondem a favor da plataforma e que a compreensão da própria pessoa quase certamente não respondeu. Os intérpretes televisivos consentiram em ser transmitidos. Os participantes de estúdio consentiram em investigação. Em nenhum dos casos documentados fora dos corpora de estúdio há provas de que ao gesticulador foi perguntado se a sua gesticulação poderia ser usada para construir uma máquina que gesticula.
Em nenhum dos casos documentados fora dos corpora de estúdio há provas de que ao gesticulador foi perguntado se a sua gesticulação poderia ser usada para construir uma máquina que gesticula.
A segunda pergunta é o pagamento. As pessoas cuja gesticulação produziu os maiores corpora não receberam nada por isso, porque os corpora foram construídos a partir de trabalho que já tinham feito por outras razões ou por nenhuma razão. Os intérpretes foram pagos pelas estações de televisão para interpretar. Quem carregou os vídeos não foi pago por ninguém. Apenas os participantes de estúdio receberam alguma coisa, e receberam compensação de investigação, não uma parte num ativo comercial. Bragg e colegas notam que os acordos de dados “podem especificar compensação pelo uso, descrever os usos permitidos dos dados” e estabelecer limites temporais de utilização[1]. Os corpora públicos documentados não o fazem porque não foram construídos com base em acordos com gesticuladores. Foram construídos com base em acordos com plataformas e estações de televisão.
A terceira pergunta é a autoria, no sentido de saber de quem é a língua que o sistema aprendeu. Um corpus de intérpretes aprendeu interpretação, com o seu desfasamento, a sua sombra da língua de origem e o seu registo profissional. Um corpus com todos os níveis de competência encontrados numa plataforma de vídeo aprendeu uma mistura de gesticulação nativa, gesticulação de segunda língua e gesticulação de aprendizes, ponderada por tudo o que as pessoas por acaso carregaram. Bragg e colegas notam que “a maioria dos utilizadores de língua gestual pode não ser surda, e os gesticuladores de primeira língua constituem apenas uma pequena fração dos utilizadores para a maioria das línguas gestuais”[1], e um corpus reunido a partir de vídeo público herda essa proporção. Uma revisão liderada por pessoas surdas de 101 artigos de IA de língua gestual constatou que o campo é “dominado por investigadores ouvintes que não gesticulam” e “guiado por aquilo que as decisões são mais convenientes ou são percebidas como importantes para investigadores ouvintes”[9]. A conveniência é também o que decide qual corpus é usado. A questão de qual é a língua que um sistema fala é resolvida, na prática, por quais gravações foram mais fáceis de obter.
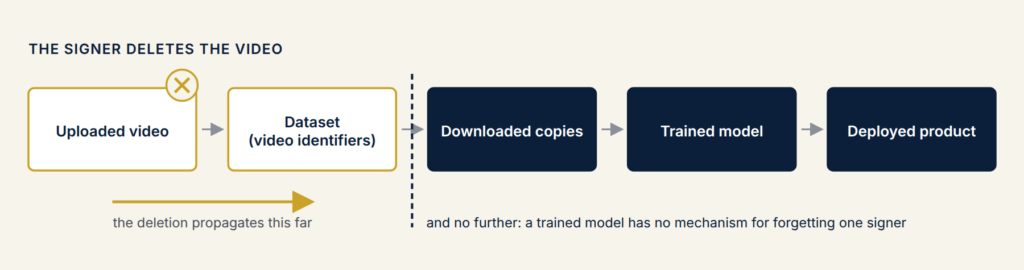
A quarta pergunta é a retirada. Uma pessoa que aparece num conjunto de dados reunido a partir de vídeo público pode eliminar o vídeo. Se o conjunto de dados foi distribuído como identificadores de vídeo, a eliminação propaga-se para quem ainda não tenha descarregado o clipe. Não se propaga para quem já o tenha feito, nem se propaga para um modelo que foi treinado antes da eliminação. O corpus televisivo é o único caso documentado com uma obrigação contratual de eliminação, e essa obrigação vai da estação de televisão para o investigador, não do intérprete para ninguém. Um modelo treinado não tem qualquer mecanismo para esquecer um gesticulador. A retirada, no sentido em que uma pessoa a entenderia, não está disponível em lado nenhum do panorama documentado uma vez que o treino tenha ocorrido.
A lacuna na lei
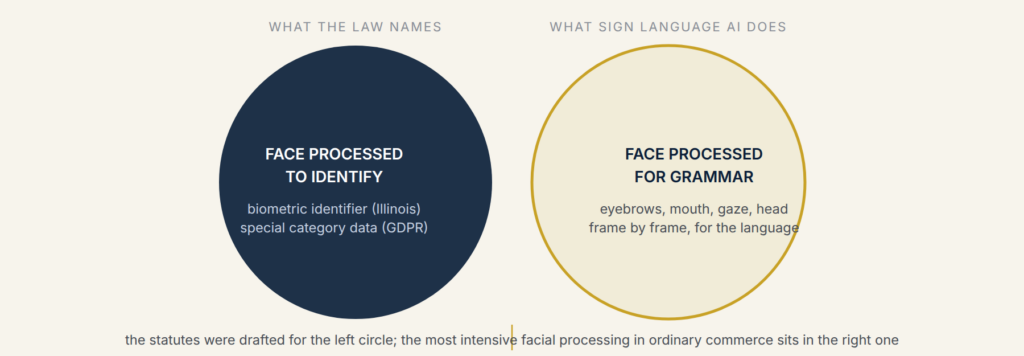
Os leitores que assumem que os rostos estão protegidos pela lei de privacidade biométrica devem observar como essa lei está redigida. A Lei de Privacidade de Informação Biométrica do Illinois, a mais estrita dos estatutos americanos, define um identificador biométrico como “uma digitalização da retina ou íris, impressão digital, impressão vocal, ou digitalização da geometria da mão ou do rosto” e exclui expressamente fotografias da definição; exige uma autorização escrita antes de uma entidade privada recolher tal identificador[10]. Ao abrigo dos regimes europeu e britânico de proteção de dados, os dados biométricos tornam-se dados de categoria especial quando são processados “com o objetivo de identificar univocamente uma pessoa singular”, e o regulador do Reino Unido é explícito ao afirmar que fotografias e vídeos comuns de pessoas “não são automaticamente dados biométricos mesmo que sejam usados para fins de identificação”; o estatuto de categoria especial aplica-se quando um processamento técnico específico produz um modelo para correspondência[11].
Um modelo de língua gestual processa o rosto com um detalhe extraordinário. Extrai a posição das sobrancelhas, a forma da boca, a direção do olhar e o movimento da cabeça, fotograma a fotograma, porque essas características são a gramática. Mas não os processa para identificar o gesticulador. Processa-os para aprender a língua. À luz dos estatutos, esse é exatamente o propósito para o qual as categorias biométricas não foram escritas. O processamento computacional mais intensivo do rosto de uma pessoa que existe no comércio comum pode, portanto, ficar fora das proteções que foram redigidas tendo rostos em mente, porque os redatores assumiram que um rosto só seria processado para dizer a quem pertence. Esta não é uma conclusão jurídica assente e a Novara Consulting Group não oferece qualquer parecer jurídico sobre qualquer jurisdição. É uma observação de que as categorias não se encaixam, e que um fornecedor a quem seja perguntado se o seu corpus é “dados biométricos” pode ser capaz de responder que não com perfeita boa-fé, ao mesmo tempo que detém milhares de horas de rostos surdos identificáveis.
As licenças são um assunto separado e mais simples. O corpus ao nível da palavra permite apenas uso académico e computacional. O corpus de estúdio é não comercial. O corpus televisivo é apenas para investigação, ao abrigo de um acordo que proíbe a cooperação com parceiros comerciais[7]. Um produto comercial treinado com qualquer um deles estaria a operar fora dos termos dos seus dados. Não existe qualquer mecanismo publicado para um comprador descobrir se isso aconteceu, e um comprador que leia a documentação de um fornecedor raramente encontrará uma declaração de proveniência do corpus suficientemente detalhada para o excluir.
O que um comprador herda
Uma instituição que implementa um sistema de IA de língua gestual herda o seu corpus. Herda o consentimento que foi ou não obtido, os termos de licença que foram ou não respeitados, o registo dos intérpretes ou os erros dos aprendizes, e a impossibilidade de retirada. Herda-os de uma forma específica: as pessoas surdas a quem serve estarão a observar um sistema a produzir rostos aprendidos a partir de membros da sua própria comunidade, e algumas dessas pessoas serão capazes de reconhecer de quem é esse rosto.
É por isso que a questão do corpus precede a questão da precisão. Um sistema cujo resultado é excelente mas cujo corpus foi retirado sem consentimento não resolveu um problema de governação; monetizou-o. Um sistema cujo corpus está totalmente documentado mas cujo resultado é fraco é, pelo menos, um sistema cujas falhas podem ser discutidas com as pessoas que afeta. A Convenção sobre os Direitos das Pessoas com Deficiência exige que os Estados Partes, ao desenvolverem políticas que digam respeito às pessoas com deficiência, “consultem de perto e envolvam ativamente” essas pessoas através das suas organizações representativas[12]. Um corpus reunido a partir de pessoas a quem nunca foi perguntado nada é o exemplo mais claro disponível de uma tecnologia desenvolvida sem esse envolvimento, e uma instituição que o compra também não está a consultar ninguém.
As respostas não serão, na maioria dos casos, tranquilizadoras. Isso não é razão para deixar as perguntas por fazer. É a razão para as fazer antes da assinatura, quando as respostas ainda mudam a decisão, em vez de depois da implementação, quando apenas mudam a responsabilidade. Os compradores que perguntarem primeiro estabelecerão os termos em que o resto do mercado será eventualmente obrigado a responder.
Referências
- Bragg, D., Caselli, N., Hochgesang, J. A., Huenerfauth, M., Katz-Hernandez, L., Koller, O., Kushalnagar, R., Vogler, C., and Ladner, R. E. (2021). The FATE landscape of sign language AI datasets: An interdisciplinary perspective. ACM Transactions on Accessible Computing, 14(2), Article 7. https://doi.org/10.1145/3436996
- Li, D., Rodriguez, C., Yu, X., and Li, H. (2020). Word-level deep sign language recognition from video: A new large-scale dataset and methods comparison. Proceedings of the IEEE/CVF Winter Conference on Applications of Computer Vision (WACV). Dataset documentation and licence statement at https://github.com/dxli94/WLASL
- Neidle, C., and Ballard, C. (2022). Why alternative gloss labels will increase the value of the WLASL dataset. American Sign Language Linguistic Research Project Report No. 21, Boston University. https://www.bu.edu/asllrp/rpt21/asllrp21.pdf
- Uthus, D., Tanzer, G., and Georg, M. (2023). YouTube-ASL: A large-scale, open-domain American Sign Language-English parallel corpus. Advances in Neural Information Processing Systems 36, Datasets and Benchmarks Track.
- Albanie, S., Varol, G., Momeni, L., Bull, H., Afouras, T., Chowdhury, H., Fox, N., Woll, B., Cooper, R., McParland, A., and Zisserman, A. (2021). BBC-Oxford British Sign Language dataset. arXiv:2111.03635. Dataset terms at https://www.robots.ox.ac.uk/~vgg/data/bobsl/
- Camgöz, N. C., Hadfield, S., Koller, O., Ney, H., and Bowden, R. (2018). Neural sign language translation. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 7784-7793.
- De Sisto, M., Vandeghinste, V., Egea Gómez, S., De Coster, M., Shterionov, D., and Saggion, H. (2022). Challenges with sign language datasets for sign language recognition and translation. Proceedings of the Thirteenth Language Resources and Evaluation Conference (LREC 2022), 2478-2487. https://aclanthology.org/2022.lrec-1.264
- Duarte, A., Palaskar, S., Ventura, L., Ghadiyaram, D., DeHaan, K., Metze, F., Torres, J., and Giró-i-Nieto, X. (2021). How2Sign: A large-scale multimodal dataset for continuous American Sign Language. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). Licence statement at https://how2sign.github.io/
- Desai, A., De Meulder, M., Hochgesang, J. A., Kocab, A., and Lu, A. X. (2024). Systemic biases in sign language AI research: A Deaf-led call to reevaluate research agendas. arXiv:2403.02563.
- Illinois Biometric Information Privacy Act, 740 ILCS 14/10 (definitions) and 14/15(b) (consent). https://law.justia.com/codes/illinois/chapter-740/act-740-ilcs-14/
- Information Commissioner’s Office (United Kingdom). What is special category data? Guidance on Article 9 UK GDPR, biometric data. https://ico.org.uk/for-organisations/uk-gdpr-guidance-and-resources/lawful-basis/special-category-data/what-is-special-category-data/
- United Nations (2006). Convention on the Rights of Persons with Disabilities, Article 4(3). https://www.un.org/development/desa/disabilities/convention-on-the-rights-of-persons-with-disabilities.html